AWS bổ sung công cụ tìm GPU bất thường trong các tác vụ huấn luyện trên SageMaker HyperPod
Tóm lược nhanh
“AWS công bố tính năng giám sát mới cho SageMaker HyperPod nhằm giúp các nhóm vận hành xác...”
Ý chính
- 1.AWS cho biết tính năng giám sát nâng cao hiện có tại mọi khu vực AWS hỗ trợ SageMaker HyperPod.
- 2.Bản tóm tắt chẩn đoán dùng API DetectGroupOutliers của CloudWatch để so sánh mức sử dụng, bộ nhớ, nhiệt độ, điện năng và xung nhịp của các GPU trong cùng tác vụ. GPU lệch đáng kể so với các thiết bị còn lại sẽ được đánh dấu. Cơ chế này hỗ trợ cả EKS và Slurm.
- 3.AWS cũng đưa vào các quy tắc nhận diện lỗi đã biết, gồm lỗi bộ nhớ ECC và lỗi XID của GPU. Với sự cố được phát hiện, hệ thống hiển thị tác vụ, cụm máy, nút, bộ tăng tốc và vị trí của thiết bị trong tác vụ.
- 4.Theo AWS, bộ chỉ số mặc định tự động theo dõi tình trạng cụm máy, tài nguyên máy chủ, mức sử dụng và nhiệt độ GPU, cùng tài nguyên của từng tác vụ. Dữ liệu được thu thập mỗi 30 giây; AWS ước tính phần thu thập này dùng thêm khoảng 1–2% CPU và 250–300 MB bộ nhớ.
- 5.CloudWatch là nơi lưu chỉ số mặc định mới; khách hàng cũng có thể chọn Amazon Managed Service for Prometheus. Các chỉ số nâng cao là tùy chọn vì làm tăng lượng dữ liệu gửi đến nơi lưu chỉ số và có thể phát sinh chi phí.
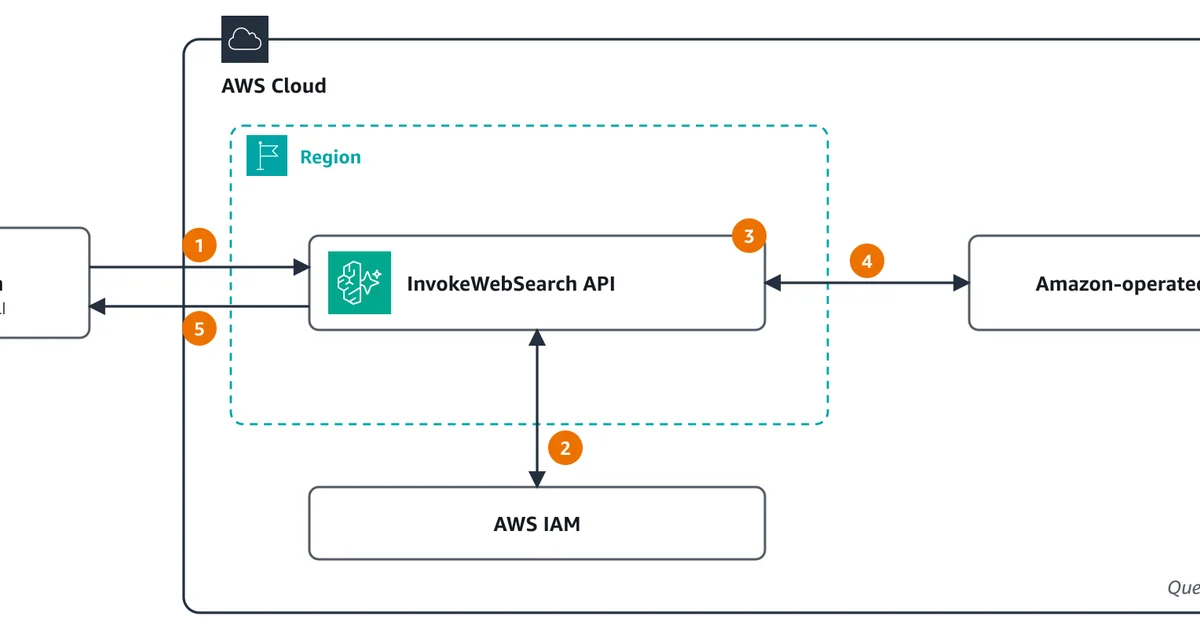
AWS công bố tính năng giám sát mới cho SageMaker HyperPod nhằm giúp các nhóm vận hành xác định GPU hoặc thành phần hạ tầng gây trục trặc khi huấn luyện mô hình. Tính năng này phục vụ các tác vụ chạy trên cả Amazon EKS và Slurm.
Chi tiết sản phẩm & Tính năng nổi bật
AWS cho biết tính năng giám sát nâng cao hiện có tại mọi khu vực AWS hỗ trợ SageMaker HyperPod.
Bản tóm tắt chẩn đoán dùng API DetectGroupOutliers của CloudWatch để so sánh mức sử dụng, bộ nhớ, nhiệt độ, điện năng và xung nhịp của các GPU trong cùng tác vụ. GPU lệch đáng kể so với các thiết bị còn lại sẽ được đánh dấu. Cơ chế này hỗ trợ cả EKS và Slurm.
AWS cũng đưa vào các quy tắc nhận diện lỗi đã biết, gồm lỗi bộ nhớ ECC và lỗi XID của GPU. Với sự cố được phát hiện, hệ thống hiển thị tác vụ, cụm máy, nút, bộ tăng tốc và vị trí của thiết bị trong tác vụ.
Theo AWS, bộ chỉ số mặc định tự động theo dõi tình trạng cụm máy, tài nguyên máy chủ, mức sử dụng và nhiệt độ GPU, cùng tài nguyên của từng tác vụ. Dữ liệu được thu thập mỗi 30 giây; AWS ước tính phần thu thập này dùng thêm khoảng 1–2% CPU và 250–300 MB bộ nhớ.
CloudWatch là nơi lưu chỉ số mặc định mới; khách hàng cũng có thể chọn Amazon Managed Service for Prometheus. Các chỉ số nâng cao là tùy chọn vì làm tăng lượng dữ liệu gửi đến nơi lưu chỉ số và có thể phát sinh chi phí.
Đánh giá thực tế & Góc nhìn chuyên môn
So sánh GPU trong cùng một tác vụ có thể giúp đội vận hành khoanh vùng thiết bị bất thường trước khi rà từng bảng chỉ số. Cảnh báo vẫn cần được đối chiếu với dữ liệu sự cố để xác định nguyên nhân.
Với cụm huấn luyện lớn, việc chọn chỉ số nâng cao đòi hỏi cân nhắc giữa mức chi tiết cần để điều tra lỗi và chi phí dữ liệu phát sinh.
Giá bán, thời điểm ra mắt & Điều cần theo dõi
AWS không đưa ra phép đo đối chứng cho thấy tính năng mới rút ngắn thời gian chẩn đoán bao nhiêu trong các tác vụ thực tế.
Thông tin được cung cấp chưa đủ để tính chi phí chỉ số nâng cao cho một cấu hình cụm máy cụ thể.