Harness là gì, vì sao nó quyết định AI làm tốt hay dở hơn cả việc chọn model?
Tóm lược nhanh
Tổng hợp và đối chiếu bởi gemini-2.0-flash-thinking-exp
“Đây là bài đầu tiên trong loạt 2 bài về chủ đề này.”
Các điểm cốt lõi
- 1.Đây là bài đầu tiên trong loạt 2 bài về chủ đề này.
- 2.Phần 1 sẽ giải thích harness là gì, nó gồm những thành phần nào và vì sao nó quan trọng đến vậy.
- 3.Phần 2 sẽ đi vào các nguyên tắc để bạn tự dựng harness cho nhu cầu riêng của mình, dù bạn dùng AI để viết lách, tóm tắt tài liệu, xử lý dữ liệu hay bất kỳ việc gì khác.
Đây là bài đầu tiên trong loạt 2 bài về chủ đề này. Phần 1 sẽ giải thích harness là gì, nó gồm những thành phần nào và vì sao nó quan trọng đến vậy. Phần 2 sẽ đi vào các nguyên tắc để bạn tự dựng harness cho nhu cầu riêng của mình, dù bạn dùng AI để viết lách, tóm tắt tài liệu, xử lý dữ liệu hay bất kỳ việc gì khác. Bạn không cần biết lập trình hay có kiến thức code vẫn đọc và hiểu được nội dung này.
Harness là gì?
Trong giới làm AI hiện nay, công thức Agent = Model + Harness được LangChain và Addy Osmani (trước làm cho Google, giờ đã về Anthropic) hay dùng để mô tả cấu trúc này. Nếu bạn đã từng nghe qua các khái niệm về AI Agent mà vẫn cảm thấy mông lung về việc nó vận hành cụ thể ra sao thì công thức này sẽ giúp bạn định hình rõ hơn. Addy Osmani thậm chí còn tóm tắt một cách cực kỳ ngắn gọn và dễ nhớ rằng nếu bạn không phải là model thì bạn chính là harness.
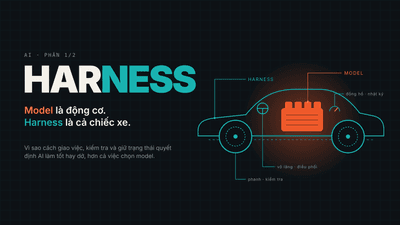
LangChain định nghĩa harness là mọi đoạn code, cấu hình và logic thực thi không phải là model. Nghe thì có vẻ trừu tượng, nhưng bạn có thể hình dung thế này, model giống như động cơ của một chiếc xe, còn harness chính là khung xe, hệ thống phanh, vô lăng và các đồng hồ đo. Động cơ mạnh mà không có phanh, không có vô lăng thì không ai dám ngồi lên chạy cả.
Vậy cụ thể thì những gì thường nằm trong phần harness này? Theo LangChain và Addy Osmani, nó bao gồm câu lệnh hệ thống (system prompt), tài liệu nạp vào, công cụ model được dùng, cùng với nơi lưu file và trạng thái. Ngoài ra, harness còn chứa các quy tắc về cách chia việc và chuyển việc giữa các bước, các bước kiểm tra tự động chạy bằng code, cũng như hệ thống nhật ký và đo lường chi phí.
Prompt, context và harness khác nhau ra sao?
Có thể hình dung quá trình làm việc với AI hiện nay đang chia thành ba tầng và mỗi tầng mới sẽ bao trùm lên tầng trước đó. Tầng đầu tiên là prompt engineering, tức là cách bạn viết câu lệnh gửi cho model sao cho rõ ràng, đúng ý. Tiếp theo là context engineering, bước này đi xa hơn câu lệnh đơn thuần để quan tâm đến việc nạp đúng tài liệu, đúng ngữ cảnh vào model, không thừa cũng không thiếu. Và tầng cao nhất chính là harness engineering, nơi bạn dựng cả một môi trường làm việc quanh model, có chia bước, có kiểm tra, có rào chắn và có lưu trạng thái.
Để dễ hình dung, hãy thử đặt một tình huống đời thường là nhờ AI đọc ảnh chụp hóa đơn rồi lập bảng chi tiêu. Nếu bạn chỉ viết "hãy đọc hóa đơn và lập bảng", đó là bạn đang ở tầng prompt engineering. Nhưng nếu bạn đưa kèm mẫu bảng mong muốn và danh mục chi tiêu cụ thể, lúc này bạn đã bước sang context engineering. Còn khi bạn thêm vào một đoạn code để cộng lại các dòng xem có khớp tổng tiền trên hóa đơn không, nếu lệch thì bắt model đọc lại và lưu lại hóa đơn nào đã xử lý xong, thì đó chính là harness engineering.
Viết prompt dài hơn chỉ giải quyết được tầng thứ nhất, muốn nạp đúng ngữ cảnh hay dựng cả môi trường làm việc quanh model thì bạn cần nhìn xa hơn câu lệnh.
Vì sao đổi harness có khi đáng giá hơn đổi model?
Thực tế cho thấy đôi khi chỉ cần thay đổi cách tổ chức môi trường làm việc, tức là đổi harness, mà kết quả lại vượt xa kỳ vọng so với việc chuyển sang một bộ não mạnh hơn. LangChain cho biết agent lập trình của họ đã leo từ khoảng hạng 30 lên khoảng hạng 5 trên bảng xếp hạng Terminal Bench 2.0 chỉ bằng cách đổi harness, trong khi giữ nguyên model. Cũng trên bảng xếp hạng này, cùng một model nhưng khi chạy trong các harness khác nhau thì điểm số chênh lệch nhau đáng kể.
Quảng cáo
OpenAI trong bài viết "Harness engineering" vào tháng 2/2026 đã kể về việc đội của họ dùng agent Codex để viết phần lớn mã nguồn cho một sản phẩm, họ nhận ra rằng mỗi khi agent làm sai, cách sửa là thêm công cụ, thêm quy tắc hoặc thêm bước kiểm tra còn thiếu, chứ không phải bảo nó "cố hơn".
Anthropic trong bài "Effective harnesses for long-running agents" công bố ngày 26/11/2025 chỉ ra rằng các agent chạy nhiều phiên hay làm quá nhiều việc một lúc rồi hết ngữ cảnh giữa chừng, dẫn đến việc chúng tưởng mình đã xong trong khi thực tế chưa, thậm chí đánh dấu hoàn thành mà chưa kiểm tra thật. Cách Anthropic xử lý không phải là đổi model, mà là thêm vào hệ thống các file ghi tiến độ, danh sách việc dạng JSON, bắt agent làm từng phần một và chỉ cho phép đánh dấu xong khi đã kiểm tra xác nhận.
Tóm lại, model quyết định trần năng lực tối đa mà hệ thống có thể đạt được, nhưng harness mới là thứ quyết định xem bạn có chạm được tới cái trần đó hay không.
Không có harness thì sao?
Khi bỏ qua các lớp kiểm soát bên ngoài, model thường gặp phải một loạt lỗi khá phổ biến mà không riêng gì một tác vụ cụ thể nào. Một trong những vấn đề lớn nhất là tình trạng quá tải ngữ cảnh. Nếu bạn cố nhét toàn bộ hướng dẫn, tài liệu tham khảo và ví dụ vào một lần gọi duy nhất, model sẽ dễ bỏ sót những thông tin nằm ở giữa. Nghiên cứu "Lost in the Middle" do Liu và cộng sự tại Stanford thực hiện, đăng trên tạp chí TACL năm 2024, cho thấy model xử lý thông tin tốt nhất khi dữ liệu nằm ở đầu hoặc cuối chuỗi ngữ cảnh, trong khi hiệu suất giảm đi rõ rệt khi thông tin quan trọng bị chèn vào giữa. Bạn có thể hình dung thế này, giống như khi nghe một bản ghi âm cuộc họp dài, những quyết định chốt lại ở giữa buổi nói chuyện thường là những phần dễ bị rơi khỏi bản tóm tắt nhất.
Một lỗi khác thường gặp là model cố gắng làm quá nhiều việc cùng một lúc. Theo Anthropic, khi giao cả một khối lượng công việc lớn trong một lần gọi duy nhất, model thường làm dở dang hoặc gặp lỗi giữa chừng. Điều này dẫn đến hiện tượng model tự điền thông tin để cho câu trả lời trông trọn vẹn hơn, hay còn gọi là bịa cho đầy. Ví dụ, trong một cuộc họp không ai nhắc đến hạn chót, nhưng khi yêu cầu tóm tắt, model có thể tự thêm một ngày tháng cụ thể cho đầu việc đó chỉ để hoàn thành cấu trúc câu.
Quảng cáo
Thêm vào đó, model có xu hướng tự báo cáo đã hoàn thành công việc khi thực tế chưa làm xong. Anthropic chỉ ra rằng model thường nói "đã kiểm tra" nhưng không có bằng chứng nào chứng minh nó thực sự đã thực hiện bước kiểm tra đó. Tương tự, khi để model tự đánh giá chất lượng bài làm của chính nó, nó thường chấm điểm dễ dãi hơn so với tiêu chuẩn khách quan, theo quan sát của Addy Osmani. Về dài hạn, model còn có thể lệch dần theo thời gian do bắt chước cả những mẫu xấu có sẵn trong dữ liệu, khiến các lỗi nhỏ tích tụ thành lỗi lớn, một hiện tượng mà OpenAI gọi là entropy.
Điểm chung của tất cả các lỗi trên là không thể sửa triệt để bằng cách viết prompt dài hơn. Model càng nhỏ, đặc biệt là những model chạy ngay trên máy cá nhân của bạn, thì càng cần việc được chia nhỏ thành các bước đơn giản và có một cơ chế kiểm tra độc lập đứng ngoài.
Một harness gồm những khối nào?
Sau khi đã hiểu vì sao prompt đơn thuần không đủ để giữ model đi đúng hướng, chúng ta có thể nhìn vào cấu trúc cụ thể của một hệ thống harness. Bạn có thể hình dung thế này, nếu model là động cơ thì harness chính là khung xe, hệ thống phanh và bộ điều khiển giúp động cơ đó chạy an toàn trên đường. Theo danh sách tổng hợp từ LangChain và bổ sung từ Addy Osmani, một harness hoàn chỉnh thường bao gồm 7 khối chức năng chính.
- Đầu vào và ngữ cảnh: Làm sạch dữ liệu, chỉ nạp đúng tài liệu cho từng bước.
- Chia bước và điều phối: Cắt việc lớn thành bước nhỏ, quyết định bước nào chạy trước.
- Công cụ: Những gì model được phép dùng: đọc file, tìm kiếm, chạy lệnh.
- Kiểm tra bằng code: Luật máy kiểm được 100%: định dạng, cộng tổng, từ cấm.
- Kiểm tra bằng lượt soát riêng: Một lượt model khác (hoặc cùng model, vai khác) chấm bài theo tiêu chí.
- Trạng thái và nhật ký: Lưu tiến độ ra file, ghi log để biết hỏng ở đâu, chạy tiếp được khi bị ngắt.
- Rào chắn và người duyệt: Giới hạn quyền, việc không thể hoàn tác thì con người bấm nút cuối.
Khối đầu tiên là việc xử lý đầu vào và ngữ cảnh, nơi hệ thống sẽ làm sạch dữ liệu và chỉ nạp đúng những tài liệu cần thiết cho từng bước cụ thể, thay vì ném cả kho dữ liệu vào một lúc. Tiếp theo là khối chia bước và điều phối, chịu trách nhiệm cắt một công việc lớn phức tạp thành các bước nhỏ hơn, đồng thời quyết định thứ tự thực hiện để model không bị lạc hướng giữa chừng.
Bên cạnh đó, khối công cụ xác định rõ những gì model được phép thao tác, ví dụ như đọc file, tìm kiếm thông tin hoặc chạy lệnh, giúp giới hạn phạm vi hoạt động của AI trong những gì an toàn. Điểm khác biệt lớn nhất nằm ở hai khối kiểm tra, đó là kiểm tra bằng code và kiểm tra bằng lượt soát riêng. Kiểm tra bằng code dùng để xác định những luật máy tính có thể kiểm tra chính xác 100%, như định dạng dữ liệu, phép cộng tổng hay danh sách từ cấm, trong khi kiểm tra bằng lượt soát riêng sẽ dùng một lượt model khác (hoặc cùng model nhưng đóng vai trò giám sát) để chấm điểm bài làm dựa trên các tiêu chí mềm mại hơn.
Cuối cùng là hai khối đảm bảo tính bền vững và an toàn, bao gồm trạng thái và nhật ký, cùng với rào chắn và người duyệt. Trạng thái và nhật ký giúp lưu tiến độ ra file và ghi lại log chi tiết, nhờ đó bạn có thể biết chính xác hệ thống đã hỏng ở đâu và chạy tiếp được khi bị ngắt kết nối. Rào chắn và người duyệt đóng vai trò là lớp phòng thủ cuối cùng, nơi các quyền được giới hạn chặt chẽ và bất kỳ hành động nào không thể hoàn tác đều bắt buộc phải có sự xác nhận của con người trước khi thực thi.
Workflow hay agent, cái nào cần harness hơn?
Để trả lời câu hỏi này, trước hết cần phân biệt rõ hai khái niệm mà Anthropic đã định nghĩa trong bài viết "Building effective agents". Workflow là những quy trình có các bước được định sẵn bằng code, tức là con người đã vẽ sẵn bản đồ đường đi cho AI đi theo. Ngược lại, agent là mô hình tự quyết định bước tiếp theo nên làm gì, tự động suy luận và chọn hướng đi dựa trên kết quả của từng bước trước đó. Sự khác biệt này ảnh hưởng trực tiếp đến cách chúng ta thiết kế harness, đặc biệt là mức độ phức tạp của các khối kiểm tra và rào chắn.
Với những tác vụ rõ ràng, lặp đi lặp lại như đọc hóa đơn, tóm tắt cuộc họp hay dịch tài liệu, workflow thường là lựa chọn ổn định và rẻ hơn. Vì các bước đã được định nghĩa trước, harness chỉ cần tập trung vào việc đảm bảo từng bước thực thi đúng chuẩn, không cần quá nhiều cơ chế phức tạp để giám sát sự tự do của model. Tuy nhiên, khi đối mặt với những việc mở, không thể đoán trước được số bước cần thực hiện, agent sẽ phát huy hiệu quả. Nhưng chính sự linh hoạt này cũng là con dao hai lưỡi, vì chi phí vận hành sẽ cao hơn và lỗi có thể cộng dồn từ bước này sang bước khác, khiến hệ thống dễ dàng rơi vào trạng thái hỗn loạn nếu thiếu đi những lớp rào chắn vững chắc.
Trong thực tế triển khai, Anthropic đã chỉ ra hai mẫu thiết kế harness hay được sử dụng nhất để xử lý các luồng công việc này. Mẫu đầu tiên là prompt chaining, tức là chuỗi các bước có cổng kiểm, nơi bước sau chỉ được phép chạy khi code xác nhận rằng bước trước đã đạt yêu cầu. Cách làm này giúp ngăn chặn việc AI chạy tiếp trên nền một kết quả sai lệch. Mẫu thứ hai là evaluator-optimizer, hoạt động theo cơ chế một bên làm và một bên chấm, cụ thể là model viết nội dung, sau đó một lượt model khác sẽ chấm điểm dựa trên các tiêu chí rõ ràng rồi trả về để sửa chữa. Hai mẫu này cho thấy harness không đơn thuần là chạy lệnh, mà là một hệ thống phản hồi liên tục để giữ cho chất lượng đầu ra luôn nằm trong vùng an toàn.
Lời khuyên quan trọng nhất mà Anthropic đưa ra cho người phát triển là hãy bắt đầu từ cách đơn giản nhất, chỉ thêm độ phức tạp khi thật sự cần thiết. Việc xây dựng một harness quá phức tạp ngay từ đầu sẽ tốn kém và làm tăng rủi ro khó kiểm soát, trong khi một hệ thống đơn giản nhưng có các điểm kiểm tra rõ ràng thường mang lại hiệu quả bền vững hơn cho người dùng.
Vậy chọn model còn quan trọng không?
Câu trả lời ngắn gọn là vẫn quan trọng, vì model chính là yếu tố đặt ra trần năng lực cho hệ thống, nếu model quá yếu thì harness cũng không cứu được. Tuy nhiên, với phần lớn nhu cầu hằng ngày, khoảng cách giữa một model khá có harness tốt và một model mạnh không có harness lớn hơn người ta nghĩ.
Addy Osmani cũng nhắc thêm rằng khi các model mới ra đời với khả năng vượt trội hơn, một số phần của harness sẽ trở nên thừa thãi, nên harness cũng phải được xem lại theo thời gian.
Chọn model giống như việc bạn chọn động cơ cho chiếc xe, còn chiếc xe chạy được xa hay không lại phụ thuộc vào các yếu tố khác xung quanh nó. Mình nghĩ rằng việc tập trung quá nhiều vào việc săn tìm model mới nhất mà bỏ qua việc xây dựng một harness ổn định cho công việc của riêng mình là một sai lầm phổ biến, bởi lẽ giá trị thực sự nằm ở sự kết hợp hài hòa giữa hai yếu tố này.
Anh em chờ phần 2 để mình chia sẻ các nguyên tắc giúp tự dựng harness cho việc của riêng mình nha.
Bản quyền & Xuất xứ thông tin
Bài viết này được tổng hợp và phân tích AI từ ấn phẩm Tinhte.vn. Mọi bản quyền nội dung thuộc về tác giả và toà soạn gốc.