Giới thiệu suy luận dựa trên Ấn Độ cho Kimi K3 trên Amazon Bedrock
Tóm lược nhanh
Tổng hợp và đối chiếu bởi gemini-2.0-flash-thinking-exp
“Kimi K3 là một mô hình nền tảng trọng lượng mở (FM) đa phương thức mà nhà cung cấp Moonshot AI đã bá”
Các điểm cốt lõi
- 1.Kimi K3 là một mô hình nền tảng trọng lượng mở (FM) đa phương thức mà nhà cung cấp Moonshot AI đã báo cáo đã đạt được mã hóa cấp độ biên giới và trí thông minh tổng thể khi phát hành.
- 2.Ngoài suy luận toàn cầu và có trụ sở tại Hoa Kỳ, Amazon Bedrock hiện hỗ trợ suy luận trong nước ở Ấn Độ cho Kimi K3: bỏ chặn khối lượng công việc cục bộ với các yêu cầu nghiêm ngặt về nơi lưu trữ dữ liệu.
- 3.Những khách hàng như Ultrahuman đã thấy được lợi ích trong quá trình sản xuất: "Jade, trợ lý Sức khỏe và Sức khỏe AI trong ứng dụng Ultrahuman, trả lời các câu hỏi bằng ngôn ngữ đơn giản bằng cách sử dụng dữ liệu Ring và glucose của riêng mỗi người, qua hơn 14.000 cuộc trò chuyện mỗi ngày.
Kimi K3 là một mô hình nền tảng trọng lượng mở (FM) đa phương thức mà nhà cung cấp Moonshot AI đã báo cáo đã đạt được mã hóa cấp độ biên giới và trí thông minh tổng thể khi phát hành. Ngoài suy luận toàn cầu và có trụ sở tại Hoa Kỳ, Amazon Bedrock hiện hỗ trợ suy luận trong nước ở Ấn Độ cho Kimi K3: bỏ chặn khối lượng công việc cục bộ với các yêu cầu nghiêm ngặt về nơi lưu trữ dữ liệu. Những khách hàng như Ultrahuman đã thấy được lợi ích trong quá trình sản xuất:
"Jade, trợ lý Sức khỏe và Sức khỏe AI trong ứng dụng Ultrahuman, trả lời các câu hỏi bằng ngôn ngữ đơn giản bằng cách sử dụng dữ liệu Ring và glucose của riêng mỗi người, qua hơn 14.000 cuộc trò chuyện mỗi ngày. Kimi K3 trên Amazon Bedrock cho phép chúng tôi thêm một mô hình trọng lượng mở hàng đầu thông qua API mà chúng tôi đã sử dụng, với dữ liệu sức khỏe được lưu trữ trong AWS và Mumbai làm Khu vực dự phòng. Với bộ nhớ đệm nhanh chóng, chúng tôi đã cắt giảm 80% chi phí LLM và thực hiện các cuộc trò chuyện nhiều lượt nhanh hơn 85%. " — Aditya Patawari, VP Kỹ thuật, Ultrahuman
Trong bài đăng này, chúng tôi giải thích các tùy chọn suy luận địa lý và toàn cầu khác nhau có sẵn, đồng thời chia sẻ mã cho một trường hợp sử dụng mẫu: nhận dạng ký tự quang học (OCR) và hiểu các tài liệu ngôn ngữ Ấn Độ, cùng với câu trả lời câu hỏi tiếp theo bằng Hinglish hỗn hợp mã. Chọn nơi suy luận có thể chạy Kimi K3 trên Amazon Bedrock được cung cấp thông qua hồ sơ suy luận giữa các khu vực. Bạn có thể gọi mô hình từ bất kỳ Khu vực AWS nào (“nguồn”). Sau đó, Amazon Bedrock sẽ xử lý yêu cầu của bạn một cách an toàn tại một trong nhiều Khu vực “đích” có thể. Suy luận liên khu vực được quản lý hoàn toàn bởi AWS: Dữ liệu được mã hóa khi truyền giữa các Khu vực và duy trì trên mạng AWS, không bao giờ truyền qua Internet công cộng hoặc yêu cầu bạn thiết lập bất kỳ cơ sở hạ tầng đám mây riêng ảo (VPC) đa khu vực nào. ID hồ sơ suy luận mà bạn gọi sẽ kiểm soát Khu vực đích nào đủ điều kiện:
Hồ sơ Mã mẫu Khi nào nên chọn nó
Toàn cầu toàn cầu.moonshotai.kimi-k3 Được đề xuất cho hầu hết các trường hợp sử dụng: chi phí thấp nhất và có sẵn rộng rãi nhất
địa lý Ấn Độ in.moonshotai.kimi-k3 Quá trình xử lý suy luận phải diễn ra trong Khu vực Mumbai và Hyderabad
Xem thẻ mô hình Amazon Bedrock Kimi K3 để biết thông tin cập nhật về các cấu hình suy luận có sẵn, chúng có thể được gọi từ những Khu vực AWS nào và những Khu vực đích nào chúng có thể sử dụng để suy luận. Hướng dẫn ví dụ: Hiểu tài liệu bằng ngôn ngữ Ấn Độ Hãy xem xét một trường hợp sử dụng mẫu: đọc tài liệu tiếng Hindi được quét, trích xuất dữ liệu có cấu trúc và trả lời các câu hỏi tiếp theo bằng cả tiếng Hindi và tiếng Anh (Hinglish). Nhu cầu này phổ biến trong các dịch vụ tài chính và quy trình làm việc của khu vực công của Ấn Độ, nơi các biểu mẫu biết khách hàng (KYC), hóa đơn điện nước và các tài liệu tương tự thường phải được số hóa. Kimi K3 trên Amazon Bedrock có thể trực tiếp đọc và suy luận về hình ảnh, bao gồm cả những hình ảnh chứa văn bản đa ngôn ngữ. Nó cung cấp một giải pháp tiềm năng mà không cần dịch vụ dịch thuật hoặc OCR riêng biệt. Điều kiện tiên quyết Mã nguồn đầy đủ cho ví dụ này có sẵn trên GitHub. Để làm theo, bạn cần:
Một tài khoản AWS. Đã cài đặt Python 3.11 trở lên, có quyền truy cập Internet để cài đặt các gói PyPI cần thiết. Đã cài đặt Giao diện dòng lệnh AWS (AWS CLI), với thông tin xác thực được định cấu hình với đủ quyền AWS Identity and Access Management (IAM) để gọi mô hình Kimi K3 thông qua hồ sơ suy luận Ấn Độ.
Ví dụ: để sử dụng Kimi K3 thông qua Vùng Mumbai ap-south-1 với suy luận địa lý ở Ấn Độ, chính sách IAM sau sẽ cấp đủ quyền truy cập. Thay thế phần giữ chỗ {ACCOUNT_ID} bằng ID tài khoản AWS của bạn:
{ "Phiên bản": "2012-10-17", "Tuyên bố": [ { "Sid": "BedrockCallWithBearerToken", "Hiệu ứng": "Cho phép", "Hành động": ["nền tảng:CallWithBearerToken"], "Tài nguyên": ["*"] }, { "Sid": "BedrockKimiK3India", "Hiệu ứng": "Cho phép", "Hành động": [ "nền tảng: InvokeModel", "nền tảng: InvokeModelWithResponseStream" ], "Tài nguyên": [ "arn:aws:bedrock:ap-south-1::foundation-model/moonshotai.kimi-k3", "arn:aws:bedrock:ap-south-2::foundation-model/moonshotai.kimi-k3", "arn:aws:bedrock:ap-south-1:{ACCOUNT_ID}:inference-profile/in.moonshotai.kimi-k3", "arn:aws:bedrock:ap-south-1:{ACCOUNT_ID}:project/default" ] } ] }
Để biết thêm thông tin về quyền, hãy xem Điều kiện tiên quyết để chạy suy luận mô hình trong Hướng dẫn sử dụng Amazon Bedrock. Nếu tổ chức của bạn hạn chế Khu vực AWS, hãy yêu cầu quản trị viên của bạn xem lại hướng dẫn IAM và SCP suy luận giữa các khu vực theo địa lý. Giữ Khu vực nguồn được cho phép và cho phép định tuyến tới cả hai điểm đến ở Ấn Độ, sử dụng ngoại lệ trong phạm vi hồ sơ nếu thích hợp. Hướng dẫn API phản hồi cũng mô tả quyền truy cập dự án mặc định bắt buộc. Bắt đầu với API suy luận Như chi tiết trên thẻ mô hình, Amazon Bedrock hỗ trợ nhiều API để gọi Kimi K3, tất cả đều thuộc điểm cuối Bedrock Runtime:
API Định dạng yêu cầu và phản hồi
Hoàn thành cuộc trò chuyện Đầu vào tin nhắn tương thích với OpenAI và đầu ra tin nhắn trợ lý.
Phản hồi Các mục đầu vào và đầu ra có cấu trúc tương thích với OpenAI.
trò chuyện Thông báo, khối nội dung và tham số suy luận được chuẩn hóa trên các mô hình được hỗ trợ.
GọiModel Nội dung yêu cầu và phản hồi JSON dành riêng cho từng mô hình.
Vì các API tương thích với OpenAI được khuyến nghị cho mô hình này nên chúng tôi sử dụng các API đó trong ví dụ này và kết nối thông qua Thư viện Python openai. Amazon Bedrock hỗ trợ tạo khóa API cho các tiện ích tích hợp yêu cầu chúng. Tuy nhiên, AWS khuyên bạn nên sử dụng thông tin xác thực có thời hạn sử dụng ngắn hạn nếu có thể. Thư viện Python của trình tạo mã thông báo AWS lấy mã thông báo giống khóa API ngắn hạn từ chuỗi thông tin xác thực AWS CLI tiêu chuẩn. Nếu sử dụng hồ sơ được đặt tên cho AWS CLI, trước tiên bạn có thể cần đặt biến môi trường AWS_PROFILE. Sau khi thông tin đăng nhập CLI được thiết lập, bạn có thể gọi mô hình bằng mã sau:
từ nhập aws_bedrock_token_generator cung cấp_token từ openai nhập OpenAI
vùng = "ap-nam-1" model_id = "in.moonshotai.kimi-k3"
khách hàng = OpenAI( base_url=f"https://bedrock-runtime.{khu vực}.amazonaws.com/openai/v1", api_key=provide_token(khu vực=khu vực), )
phản hồi = client.chat.completions.create( mô hình=model_id, tin nhắn=[{ "vai trò": "người dùng", "content": "Phân loại yêu cầu này là thanh toán, kỹ thuật hoặc tài khoản: Tôi đã bị tính phí hai lần." }], max_completion_tokens=2048, )
print(response.choices[0].message.content)
Ở đây, khu vực (ap-south-1 Mumbai) chỉ định Khu vực nguồn mà yêu cầu được thực hiện. Hồ sơ suy luận in.moonshotai.kimi-k3 đảm bảo rằng suy luận chỉ được xử lý ở các Khu vực Ấn Độ. Một loạt các tính năng như phát trực tuyến, gọi công cụ và kết quả đầu ra có cấu trúc được hỗ trợ trên cả API Hoàn thành trò chuyện và Phản hồi. Xem Tài liệu tham khảo API Python của OpenAI để biết thêm ví dụ. Phân tích hình ảnh Kimi K3 trên Amazon Bedrock hỗ trợ hình ảnh cũng như tệp PDF và nhiều loại tệp khác. Bạn có thể gửi trực tiếp các tệp đầu vào đến mô hình bằng mã hóa base64. Đối với OCR hoặc các trường hợp sử dụng khác trong đó chi tiết nhỏ đóng vai trò quan trọng, hãy cân nhắc đặt thông số chi tiết hình ảnh ở mức cao. Điều này cải thiện độ chính xác, với chi phí sử dụng nhiều mã thông báo đầu vào hơn cho mỗi hình ảnh. Trong một số trường hợp, chúng tôi nhận thấy chất lượng đầu ra của Kimi K3 cao hơn khi hình ảnh được cung cấp trước khi nhập văn bản. Chúng tôi khuyên bạn nên thử nghiệm việc đặt hàng theo yêu cầu. Hãy xem xét mã ví dụ sau:
từ base64 nhập b64encode
image_path = "sample_data/electricity_bill_hi.png" với open(image_path, "rb") là f: image_base64 = b64encode(f.read()).decode("ascii")
phản hồi = client.chat.completions.create( mô hình=model_id, tin nhắn=[ { "vai trò": "người dùng", "nội dung": [
Thẻ mẫu khuyến nghị đặt hình ảnh trước văn bản:
{ "loại": "image_url", "image_url": { "url": f"data:image/png;base64,{image_base64}", "chi tiết": "cao" } }, {"loại": "văn bản", "văn bản": QUESTION_PROMPT}, ] }, ], max_completion_tokens=16384, )
print(response.choices[0].message.content)
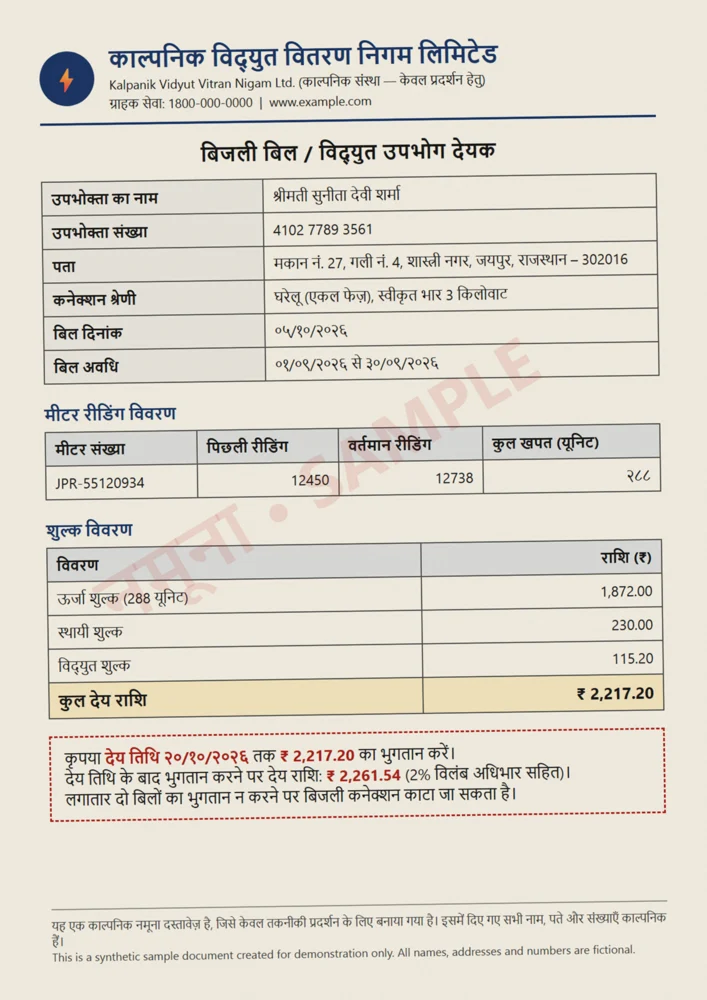
Để chứng minh, chúng tôi đã tạo ra hình ảnh hóa đơn tiền điện tổng hợp bằng tiếng Hindi.
Hình 1: Hóa đơn tiền điện tiếng Hindi tổng hợp từ mẫu (tất cả tài liệu mẫu đều là hư cấu)
Với hình ảnh đầu vào này, mô hình có thể trả lời các câu hỏi bằng cách lấy dữ liệu trực tiếp từ tài liệu mà không cần bước số hóa riêng biệt. Ví dụ: Q: Bill kitne ka hai aur ngày cuối cùng kab hai? Late hua toh kitna dena padega? A: Tổng số hóa đơn là ₹ 2.217,20 hai, vào ngày cuối cùng là 20/10/2026 hai. Late hua toh ₹2.261,54 dena padega. Xây dựng một đường ống khai thác có cấu trúc Ngoài việc trả lời câu hỏi chung, bạn có thể tạo quy trình xử lý tài liệu có cấu trúc bằng cách sử dụng lời nhắc tĩnh để trích xuất một tập hợp nhất quán các trường dự kiến trên nhiều tài liệu. Để áp dụng các ràng buộc chắc chắn về cấu trúc đầu ra (thay vì tạo theo hướng dẫn nhanh chóng với nỗ lực tối đa), Kimi K3 hỗ trợ đầu ra có cấu trúc trên Amazon Bedrock thông qua lệnh gọi hàm hoặc bằng cách cung cấp định dạng đầu ra Lược đồ JSON. Các tùy chọn này được mô tả chi tiết hơn trong tài liệu OpenAI (dành cho các API tương thích với OpenAI) và Hướng dẫn sử dụng Amazon Bedrock (dành cho các API Converse/InvokeModel gốc). Trong kho lưu trữ mã mẫu đầy đủ, chúng tôi đã cung cấp một quy trình từ đầu đến cuối:
Phiên âm tài liệu ở dạng chữ viết gốc (OCR). Trích xuất các trường khóa dưới dạng JSON bằng lược đồ có thể định cấu hình, với ngày được chuẩn hóa thành ISO 8601 (YYYY-MM-DD), chữ số Devanagari (ví dụ: २८८) được chuyển đổi sang chữ số phương Tây (288) và tên được phiên âm sang tiếng Anh. Viết một bản tóm tắt ngắn bằng tiếng Anh. Trả lời các câu hỏi tiếp theo nhiều lượt bằng tiếng Hinglish (tiếng Hindi viết bằng chữ Latinh, trộn với tiếng Anh) về cùng một tài liệu.
Đối với cùng một hóa đơn tiền điện bằng tiếng Hindi tổng hợp trong hình trước, quy trình trả về các trường có cấu trúc như sau (viết tắt):
{ "consumer_name": "Bạn có thể sử dụng nó", "consumer_name_english": "Smt. Sunita Devi Sharma", "consumer_number": "410277893561", "billing_ Period": "2026-09-01 đến 2026-09-30", "ngày_đến hạn": "2026-10-20", "đơn vị_consumed_kwh": 288, "số tiền_đến hạn_inr": 2217,20, "số tiền_sau_thời hạn_ngày_inr": 2261,54 }
Chúng tôi cũng đã bao gồm một ví dụ về biểu mẫu KYC và chế độ không có lược đồ kết thúc mở, trong đó mô hình sẽ tự chọn các trường hữu ích nhất cho bất kỳ loại tài liệu nào khác. Tất cả các tài liệu mẫu được cung cấp đều là tài liệu tổng hợp, có tên và địa chỉ hư cấu cũng như số nhận dạng được che giấu. Tải xuống mã mẫu từ GitHub để khám phá thêm và thử nó trên hình ảnh của riêng bạn. Giống như bất kỳ hoạt động trích xuất tự động nào, bạn nên xác minh kết quả đầu ra có đáng tin cậy cho trường hợp sử dụng cụ thể của mình hay không trước khi dựa vào chúng để đưa ra các quyết định quan trọng. Hãy cân nhắc thêm logic sau xác thực hoặc bước đánh giá của con người đối với các quy trình công việc quan trọng. Tối ưu hóa hiệu suất giá, tầng dịch vụ và bộ nhớ đệm Điều chỉnh các lời nhắc và lược đồ hệ thống của bạn dựa trên các tài liệu mẫu để trích xuất đáng tin cậy. Tối ưu hóa lời nhắc nâng cao của Amazon Bedrock (AdvPO) cung cấp tùy chọn được quản lý hoàn toàn để tối ưu hóa các mẫu lời nhắc dựa trên các ví dụ tham khảo. Các bậc dịch vụ của Amazon Bedrock cho phép bạn kiểm soát hiệu suất giá trên cơ sở từng yêu cầu. Đối với các trường hợp ít nhạy cảm với độ trễ hơn, bạn có thể chọn bậc linh hoạt để được giảm giá 50% so với mức giá tiêu chuẩn mặc định. Đối với các trường hợp quan trọng về độ trễ, bạn có thể chọn “ưu tiên” để yêu cầu mức độ ưu tiên hàng đợi cao hơn với mức giá cao hơn. Xem trang giá để biết chi tiết. Các trường hợp sử dụng có nội dung dài, hiếm khi thay đổi trong lời nhắc đầu vào cũng có thể được hưởng lợi từ bộ nhớ đệm nhanh trên Amazon Bedrock. Đảm bảo nội dung tĩnh (lời nhắc hệ thống, mô tả công cụ, v.v.) xuất hiện ở đầu dữ liệu nhập, trước các phần động như hình ảnh và câu hỏi hiện tại. Kimi K3 trên Amazon Bedrock hỗ trợ cả mức giá chiết khấu cho các lần truy cập bộ nhớ đệm cũng như chế độ bộ nhớ đệm rõ ràng. Ở chế độ bộ nhớ đệm ẩn mặc định, dịch vụ sẽ cố gắng tự động lưu vào bộ nhớ đệm và sử dụng lại các tiền tố lời nhắc lặp lại giữa các yêu cầu mà không cần người dùng thực hiện hành động nào. Tuy nhiên, bạn có thể cải thiện hiệu suất bằng cách chọn chế độ rõ ràng và chỉ định 'điểm dừng' của nội dung có thể lưu trong bộ nhớ đệm trong đầu vào của mình, tăng tốc độ nhấn bộ nhớ đệm, tốc độ phản hồi và tiết kiệm chi phí. Ví dụ sau đây hiển thị bộ nhớ đệm nhanh chóng rõ ràng với API phản hồi. Để biết thêm thông tin, hãy xem bộ nhớ đệm nhanh chóng trong Hướng dẫn sử dụng Amazon Bedrock:
để gọi vào (1, 2): phản hồi = client.responses.create( model=model_id, max_output_tokens=2048, store=False, đầu vào=[ {"loại": "tin nhắn", "vai trò": "hệ thống", "nội dung": [{ "loại": "input_text", "văn bản": static_prefix, "prompt_cache_breakpoint": {"mode": "rõ ràng"}, }]}, {"loại": "tin nhắn", "vai trò": "người dùng", "nội dung": [{ "loại": "input_text", "văn bản": Dynamic_prompt, }]}, ], extra_body={"prompt_cache_options": {"mode": "rõ ràng"}}, ) in (gọi, phản hồi.usage.input_tokens_details.cached_tokens)
Giám sát việc sử dụng Số liệu của Amazon CloudWatch được tạo tự động cho Kimi K3 trong không gian tên AWS/Bedrock, cung cấp khả năng hiển thị tốc độ gọi, số lượng mã thông báo, mức sử dụng bộ nhớ đệm, độ trễ, lỗi và điều tiết. Ghi nhật ký lệnh gọi mô hình được chọn tham gia và có thể tùy ý chứa lời nhắc và kết quả đầu ra. Xem lại cài đặt quyền truy cập, lưu giữ và vị trí lưu trữ trước khi bật. Nhật ký và số liệu được lưu trữ trong Khu vực nguồn nơi bạn gửi yêu cầu của mình, bất kể Khu vực đích nào có thể đã xử lý yêu cầu đó trong suy luận giữa các Khu vực. Bạn có thể tùy ý bật tính năng ghi nhật ký sự kiện dữ liệu AWS CloudTrail để ghi nhật ký các lệnh gọi mô hình trong CloudTrail, nơi ghi lại Vùng đích của yêu cầu dưới dạng trường AddedEventData.inferenceRegion. Dọn dẹp Kimi K3 được tính phí trên cơ sở mỗi mã thông báo, vì vậy các mẫu mã này không cung cấp bất kỳ tài nguyên AWS liên tục nào để dọn dẹp. Nếu bạn đã tạo Vai trò hoặc Người dùng IAM mới để khám phá hoặc thêm các quyền bổ sung cho Người dùng/Vai trò hiện tại của mình, hãy nhớ xóa chúng khi bạn hoàn tất. Kết luận và các bước tiếp theo Trong bài đăng này, chúng tôi đã khám phá cách Kimi K3 trên Amazon Bedrock cung cấp thông tin theo yêu cầu có khả năng hiểu các ngôn ngữ Ấn Độ và tiếng Anh hỗn hợp. Hiện tại, nó hỗ trợ xử lý dữ liệu hoàn toàn trong nước ở Ấn Độ (Khu vực AWS Mumbai và Hyderabad) thông qua hồ sơ suy luận in.moonshotai.kimi-k3. Hãy dùng thử ngay hôm nay trong bảng điều khiển Amazon Bedrock hoặc thông qua API suy luận. Hãy xem thẻ mô hình để biết thêm thông tin và truy cập AWS re:Post để tìm câu trả lời hoặc hỏi cộng đồng về Amazon Bedrock.
Về các tác giả