Hiệu suất cao hơn từ mỗi byte: Cách thiết kế mã đầy đủ giải quyết thách thức về bộ nhớ của AI
Tóm lược nhanh
Tổng hợp và đối chiếu bởi gemini-2.0-flash-thinking-exp
“Các mô hình lớn hơn, bối cảnh dài hơn và các ứng dụng tác nhân đang làm tăng áp lực bộ nhớ GPU trong”
Các điểm cốt lõi
- 1.Các mô hình lớn hơn, bối cảnh dài hơn và các ứng dụng tác nhân đang làm tăng áp lực bộ nhớ GPU trong khi nguồn cung thắt chặt và giá tăng - một xu hướng dự kiến sẽ tiếp tục trong thời gian tới.
- 2.NVIDIA hợp tác chặt chẽ với các đối tác bộ nhớ để nhanh chóng áp dụng các công nghệ bộ nhớ mới nhất.
- 3.NVIDIA là công ty đầu tiên áp dụng công nghệ HBM3e và HBM4 vào hệ thống tính toán tăng tốc.
Các mô hình lớn hơn, bối cảnh dài hơn và các ứng dụng tác nhân đang làm tăng áp lực bộ nhớ GPU trong khi nguồn cung thắt chặt và giá tăng - một xu hướng dự kiến sẽ tiếp tục trong thời gian tới. NVIDIA hợp tác chặt chẽ với các đối tác bộ nhớ để nhanh chóng áp dụng các công nghệ bộ nhớ mới nhất. NVIDIA là công ty đầu tiên áp dụng công nghệ HBM3e và HBM4 vào hệ thống tính toán tăng tốc. Nhưng cách tiếp cận không chỉ đơn giản là tăng thêm bộ nhớ cho GPU. Đó là codesign toàn ngăn xếp. NVIDIA có chủ đích thiết kế GPU, CPU, mạng, bộ lưu trữ và phần mềm cùng nhau để đạt được nhiều công việc hữu ích hơn từ bộ nhớ ở mọi lớp của nhà máy AI. Điều đó quan trọng vì một nhà máy AI chạy trên hệ thống phân cấp bộ nhớ và lưu trữ. Bộ nhớ băng thông cao GPU (HBM) là cấp nhanh nhất, đắt nhất và gây tranh cãi nhất — với trọng lượng model và bộ đệm KV cạnh tranh để có dung lượng hạn chế. Bên dưới nó là bộ nhớ CPU, ổ SSD cục bộ và bộ nhớ dùng chung, mỗi tốc độ giao dịch để có nhiều dung lượng hơn với chi phí mỗi bit thấp hơn. Mức độ hữu ích của một byte phụ thuộc vào mức độ sử dụng toàn bộ hệ thống phân cấp: thu nhỏ những gì phải được lưu trữ, đặt nó vào đúng tầng và đưa nó trở lại GPU trước khi cần. Byte for byte, NVIDIA tận dụng bộ nhớ hiệu quả nhất ở mọi lớp — và kết quả đã cho thấy điều đó. Từ NVIDIA Blackwell Ultra đến nền tảng Vera Rubin, công suất HBM trên mỗi GPU đã tăng khoảng 3%, trong khi thông lượng tác nhân trên mỗi đô la tăng tới 30 lần trên SemiAnalysis AgentX. Suy luận tác nhân đang gây thêm áp lực cho HBM Các mô hình biên giới hiện có hàng nghìn tỷ tham số — những giá trị chứa đựng những gì mô hình AI đã học được trong quá trình đào tạo. Bộ đệm KV, nơi lưu giữ bối cảnh mà mô hình cần để hiểu từng yêu cầu đang hoạt động mà không cần xử lý lại thông tin tương tự, cũng đang được mở rộng. Các quỹ đạo tác nhân mang bối cảnh trước đó qua các lệnh gọi mô hình và công cụ lặp lại, trong một số trường hợp xử lý tới 3 triệu mã thông báo, do đó bộ nhớ làm việc của mỗi yêu cầu sẽ tăng theo thời gian. Thế hệ tăng cường truy xuất (RAG) thêm thông tin doanh nghiệp có liên quan vào lời nhắc, tạo ra nhiều ngữ cảnh hơn để xử lý và lưu giữ. Trong quá trình suy luận, HBM chủ yếu chứa cả tham số mô hình và bộ đệm KV. Kết quả: áp lực lớn hơn lên HBM.
Tại sao các nhà máy AI cần có hệ thống phân cấp bộ nhớ Việc bổ sung thêm dung lượng HBM cho mỗi GPU là phản ứng rõ ràng trước áp lực đó, nhưng dung lượng chỉ mang lại những gì băng thông có thể di chuyển. Hãy coi HBM như một nhà kho và băng thông bộ nhớ như bến tải của nó. Một nhà kho lớn hơn chứa nhiều hàng tồn kho hơn, nhưng các bến cảng sẽ ấn định số lượng có thể nhập và xuất tại một thời điểm. Khi các bến cảng đã hết công suất, việc di chuyển nhiều hàng tồn kho hơn sẽ mất nhiều thời gian hơn và làm chậm thời gian phản hồi. Nếu độ trễ vượt quá mức dịch vụ yêu cầu thì không gian bổ sung sẽ không thể được sử dụng hiệu quả, ngay cả khi nó làm tăng thêm chi phí và tiêu hao điện năng. Đó cũng là lý do tại sao không có hoạt động nào giữ tất cả hàng tồn kho của mình ở không gian gần nhất, nhanh nhất. Những gì đang chuyển động vẫn ở gần đường thẳng. Những gì đang chờ đợi sẽ di chuyển đến một không gian lớn hơn, rẻ hơn ở gần đó và quay trở lại trước khi cần đến. Một nhà máy AI cũng phải đối mặt với giới hạn tương tự. Nhiều HBM hơn có thể chứa nhiều bộ đệm KV hơn và hỗ trợ nhiều người dùng đồng thời hơn. Mỗi người dùng được thêm sẽ chia sẻ cùng một băng thông điện toán và bộ nhớ. Nhưng khi mỗi người dùng mong đợi phản hồi nhanh thì cuối cùng băng thông bộ nhớ không thể cung cấp dữ liệu nhanh như khả năng máy tính có thể sử dụng: một giới hạn mà các kỹ sư gọi là bức tường bộ nhớ. Quá thời điểm đó, công suất HBM bổ sung không thể được đưa vào hoạt động nhưng nó vẫn làm tăng thêm chi phí và tiêu thụ điện năng. Dữ liệu vẫn cần một nơi để lưu trữ, nhưng không phải tất cả dữ liệu đều cần cấp độ nhanh nhất, đắt nhất. Đây là lý do tại sao một nhà máy AI quản lý dữ liệu theo hệ thống phân cấp bộ nhớ và lưu trữ.
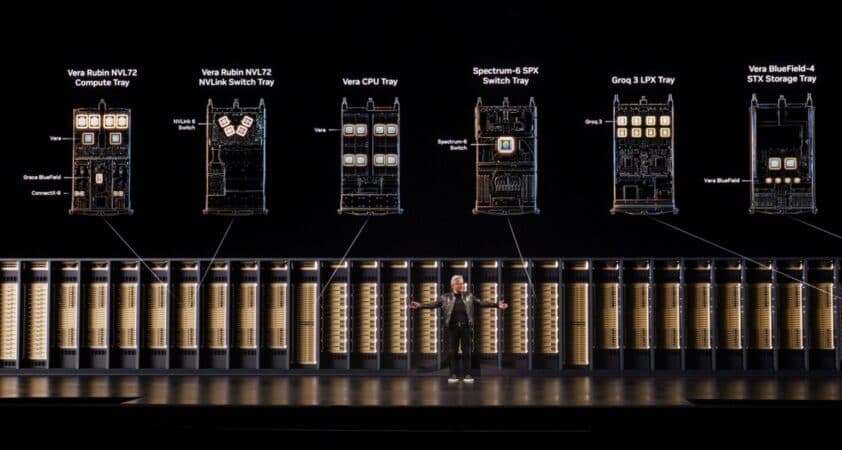
Tối đa hóa giá trị của mỗi byte với thiết kế mã đầy đủ Thiết kế mã toàn ngăn xếp của NVIDIA giúp đếm từng byte HBM bằng cách giảm bớt áp lực từ trọng lượng mô hình, bộ nhớ đệm KV và dữ liệu RAG. Nó thực hiện điều này bằng các kỹ thuật mà mỗi kỹ thuật nhắm đến một nguyên nhân dẫn đến sự kém hiệu quả khác nhau:
Thu nhỏ trọng số mô hình và phân phối chúng trên miền NVL72.
Định dạng NVFP4 giảm không gian cần thiết cho trọng số so với FP8, độ chính xác thấp nhất có thể có trên nền tảng NVIDIA Hopper. Các mô hình gần đây, bao gồm FLUX.2 [klein] từ Black Forest Labs, Inkling từ Thought Machines Lab, Beam 1.0 từ Reflection, Meta Muse Spark từ Meta, Xem trước bước 5 từ StepFun và NVIDIA Nemotron 3.5 Super VL đã được phát hành với các điểm kiểm tra NVFP4, thể hiện việc áp dụng độ chính xác 4 bit ngày càng tăng của người xây dựng mô hình để suy luận nhanh hơn, tiết kiệm bộ nhớ hơn. Trong hệ thống NVL72, trọng số mô hình có thể được phân bổ trên tối đa 72 GPU, do đó, mỗi GPU chiếm một phần nhỏ hơn trong mô hình — để lại nhiều HBM hơn cho bộ nhớ đệm KV và người dùng đồng thời.
Thu gọn KV-cache và giảm tải bối cảnh không hoạt động sang các tầng lưu trữ có chi phí thấp hơn.
Việc áp dụng NVFP4 vào bộ nhớ đệm KV giúp giảm dung lượng của nó so với FP8, do đó, nhiều ngữ cảnh hơn có thể tồn tại trong HBM. CPU NVIDIA Vera hỗ trợ theo hai cách. Việc thực thi công cụ nhanh hơn sẽ rút ngắn thời gian bộ đệm KV không hoạt động trong khi gọi công cụ và bộ nhớ LPDDR lớn của nó, được kết nối với GPU NVIDIA Rubin qua kết nối NVIDIA NVLink-C2C, giúp bối cảnh bị tạm dừng ở một nơi gần đó để chờ và quay lại nhanh chóng. Khi ngữ cảnh không được sử dụng tích cực, phần mềm suy luận NVIDIA Dynamo sẽ chuyển nó sang bộ lưu trữ bộ nhớ ngữ cảnh NVIDIA CMX — một tầng được xây dựng để có dung lượng với chi phí trên mỗi bit thấp hơn nhiều so với HBM — và trả lại ngữ cảnh đó trước khi sử dụng lại. Không giống như SSD cục bộ, CMX được chia sẻ trên các máy chủ và không giống như bộ lưu trữ doanh nghiệp, nó bỏ qua chi phí bảo vệ dữ liệu dài hạn mà bối cảnh ngắn hạn không cần. Các đối tác lưu trữ bộ nhớ ngữ cảnh NVIDIA CMX bao gồm Cloudian, DDN, Dell Technologies, Everpure (trước đây là Pure Storage), HPE, IBM, NetApp, VAST và WEKA. Tính năng Tái sử dụng bộ đệm KV của Dynamo liên kết các tầng với nhau, quản lý bộ đệm KV dưới dạng một tài nguyên toàn hệ thống trên bộ nhớ GPU, bộ nhớ CPU và bộ lưu trữ, do đó ngữ cảnh được tính toán một lần có thể được sử dụng lại trên toàn hệ thống.
Nhúng RAG nhỏ gọn và giữ chỉ mục bên ngoài HBM.
RAG biến các tài liệu doanh nghiệp thành các phần nhúng — biểu diễn bằng số cho phép hệ thống tìm kiếm theo ý nghĩa chứ không phải từ khóa — được sắp xếp thành một chỉ mục có thể tìm kiếm. Các mô hình NVIDIA Nemotron Retriever tạo ra các phần nhúng nhỏ hơn với độ chính xác truy xuất cao hơn, trong khi thư viện NVIDIA cuVS cho phép xây dựng và phân phối chỉ mục đó trên CPU và bộ lưu trữ. Cơ sở kiến thức không bao giờ chiếm lĩnh HBM và chỉ những đoạn mà mô hình cần mới được đưa vào ngữ cảnh.
Kết quả là ít HBM được sử dụng hơn cho trọng lượng mô hình, ít HBM hơn bị ràng buộc bởi bối cảnh nhàn rỗi và có nhiều HBM hơn để phục vụ người dùng đồng thời. Sản lượng hữu ích hơn trên mỗi đô la với mỗi thế hệ Qua các thế hệ nền tảng NVIDIA kế tiếp, số token trên giây trên mỗi đô la đã tăng nhanh hơn nhiều so với công suất của HBM. Trên khối lượng công việc SemiAnalysis AgentX DeepSeek V4 Pro, NVIDIA GB300 NVL72 mang lại thông lượng trên mỗi đô la cao hơn tới 10 lần so với nền tảng NVIDIA H200 với 100 mã thông báo mỗi giây cho mỗi người dùng, với công suất HBM trên mỗi GPU tăng gần gấp đôi. Với 125 token mỗi giây cho mỗi người dùng, Vera Rubin NVL72 mang lại thông lượng trên mỗi đô la cao hơn tới 30 lần so với GB300 NVL72, với công suất HBM trên mỗi GPU tăng khoảng 3%.
Đối với các nhà điều hành nhà máy AI, số liệu quan trọng là nhà máy có thể cung cấp bao nhiêu mã thông báo hữu ích trong ngân sách năng lượng của mình đồng thời đáp ứng nhu cầu về thời gian phản hồi của người dùng. Nhiều mã thông báo hơn trên giây trên mỗi watt có nghĩa là nhiều công việc và doanh thu hơn từ cùng một nguồn điện và chi phí cho mỗi mã thông báo thấp hơn. Thiết kế mã toàn ngăn xếp của NVIDIA giúp giảm chi phí mã thông báo bằng cách tăng công việc hữu ích mà mỗi byte bộ nhớ mang lại. Tìm hiểu thêm trong video giải thích và tìm hiểu sâu về kỹ thuật về cách thiết kế mã toàn ngăn xếp của NVIDIA giảm áp lực bộ nhớ suy luận.
Bản quyền & Xuất xứ thông tin
Bài viết này được tổng hợp và phân tích AI từ ấn phẩm Nvidia Blog. Mọi bản quyền nội dung thuộc về tác giả và toà soạn gốc.