AIINEWS

AIINEWS

Báo cáo chuyên sâu về Trí tuệ nhân tạo và Công nghệ toàn cầu

Tìm Kiếm Bản Tin

Tra cứu nhanh trong toàn bộ cơ sở dữ liệu các bản tin và phân tích công nghệ

Kết quả cho “mixture-of-experts”10 bản tin
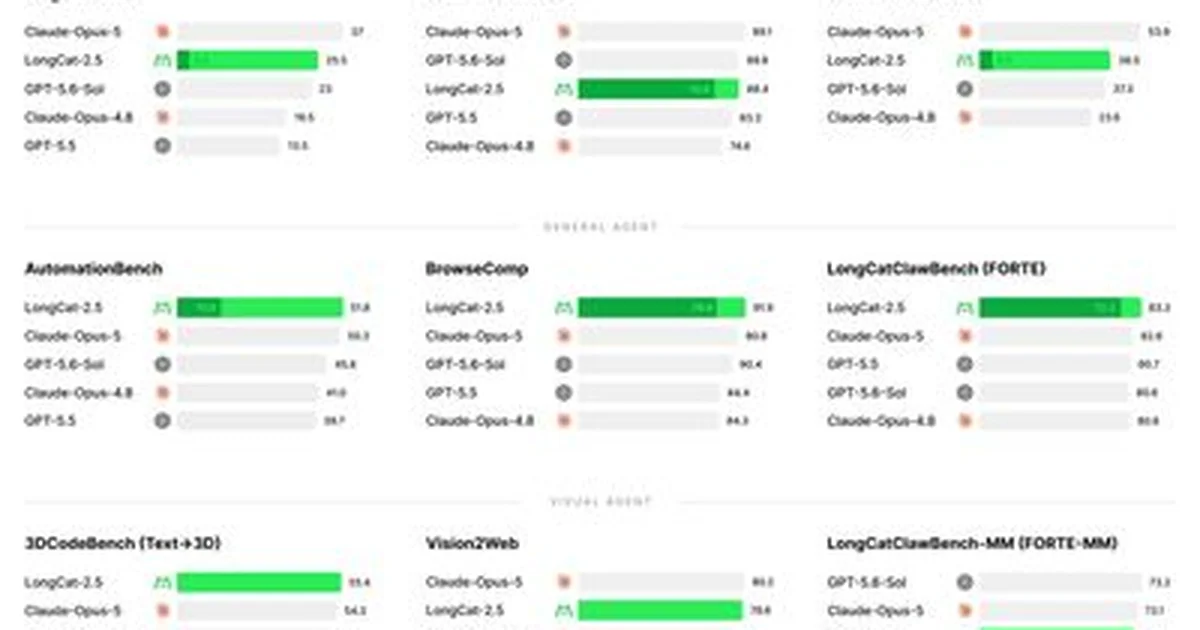
Meituan ra mắt mô hình trí tuệ nhân tạo LongCat-2,5 chạy trên chip nội địa Trung Quốc
Trí tuệ nhân tạokhoảng 2 giờ trước

Meituan ra mắt mô hình trí tuệ nhân tạo LongCat-2,5 chạy trên chip nội địa Trung Quốc

Meituan đã công bố mô hình ngôn ngữ lớn LongCat-2,5 với 1,6 nghìn tỷ tham số được thiết kế để vận hành hoàn toàn trên phần cứng nội địa Trung Quốc mà không cần dùng chip Nvidia. Hệ thống này mở trọng số theo giấy phép MIT và hỗ trợ xử lý cả văn bản, hình ảnh lẫn video.

2 phút đọc494
So sánh cơ chế định tuyến mã nguồn mở trong các mô hình hỗn hợp chuyên gia
Trí tuệ nhân tạo9 ngày trước

So sánh cơ chế định tuyến mã nguồn mở trong các mô hình hỗn hợp chuyên gia

Các mô hình hỗn hợp chuyên gia mã nguồn mở hiện nay chia sẻ chung một nguyên lý kiến trúc nhưng lại áp dụng các cơ chế định tuyến token rất khác nhau. Khảo sát mười mô hình tiêu biểu cho thấy sự dao động lớn về số lượng chuyên gia, số lượng chuyên gia hoạt động trên mỗi token và chiến lược cân bằng tải.

2 phút đọc4,239
Máy tư duy phát hành Inkling 2 nhỏ, MoE 594B với hoạt động 17B

Máy tư duy phát hành Inkling 2 nhỏ, MoE 594B với hoạt động 17B

Phòng thí nghiệm máy tư duy đã phát hành Inkling 2 Small, model đầu tiên của thế hệ Inkling thứ hai. Mô hình Inkling 2 Small là một Hỗn hợp chuyên gia (MoE) thưa thớt với tổng số 594B và 17B tham số hoạt động. Nó chấp nhận văn bản và hình ảnh, đồng thời hỗ trợ nỗ lực suy luận có thể thay đổi.

7 phút đọc5,293
Baidu phát hành Flash Base ERNIE 5.5: Mô hình cơ sở MoE 280B với thông số hoạt động 14B

Baidu phát hành Flash Base ERNIE 5.5: Mô hình cơ sở MoE 280B với thông số hoạt động 14B

Baidu đã phát hành ERNIE 5.5 Flash Base, điểm kiểm tra sơ bộ trước khi đào tạo của mô hình ngôn ngữ Mixture-of-Experts thưa thớt mới của nó. ERNIE 5.5 Flash Base là mô hình văn bản có tham số 280B của Baidu kích hoạt 14B tham số trên mỗi mã thông báo. Trọng lượng dừng lại khi kết thúc quá trình luyện tập trước và không áp dụng giữa hoặc sau quá trình luyện tập.

6 phút đọc8,815
Anthropic phát hành FlashProve: Bằng chứng mật mã cho thấy phản hồi đến từ trọng lượng đã cam kết

Anthropic phát hành FlashProve: Bằng chứng mật mã cho thấy phản hồi đến từ trọng lượng đã cam kết

Nhóm Frontier Red của Anthropic đã phát hành FlashProve, một nguyên mẫu nghiên cứu mã nguồn mở cho những suy luận có thể chứng minh được. FlashProve là một hệ thống zkSNARK của Anthropic nhằm chứng minh phản hồi đến từ một mô hình đã cam kết. Bằng chứng không tiết lộ gì về trọng lượng của mô hình.

6 phút đọc10,218
NVIDIA chỉ ra 3 cách để tăng tốc độ suy luận MoE trên DGX Spark, nâng thông lượng flash Ling-3.0 lên 42,5%
Bán dẫn & Siêu chip13 ngày trước

NVIDIA chỉ ra 3 cách để tăng tốc độ suy luận MoE trên DGX Spark, nâng thông lượng flash Ling-3.0 lên 42,5%

Blog kỹ thuật mới nhất của NVIDIA cho thấy cách tăng tốc độ suy luận của nhiều chuyên gia (MoE) trên một DGX Spark. Mô hình thử nghiệm bao gồm Ling-3.0-flash của Ant GroupAI, MoE tham số 124B với tham số hoạt động 5.1B. NVIDIA xếp chồng ba tối ưu hóa: phụ trợ nhân MoE mới, lớp đầu ra FP8 và giải mã suy đoán tích hợp.

10 phút đọc8,435