Máy chủ MCP serverless để truy cập kho dữ liệu tác nhân AI trên Amazon ECS Fargate
Tóm lược nhanh
Tổng hợp và đối chiếu bởi gemini-2.0-flash-thinking-exp
“Các tổ chức xây dựng ứng dụng được hỗ trợ bởi trí tuệ nhân tạo (AI) phải đối mặt với một thách thức”
Các điểm cốt lõi
- 1.Các tổ chức xây dựng ứng dụng được hỗ trợ bởi trí tuệ nhân tạo (AI) phải đối mặt với một thách thức thường xuyên: cấp cho các tác nhân mô hình ngôn ngữ lớn (LLM) quyền truy cập vào các hồ dữ liệu doanh nghiệp mà không trùng lặp logic tích hợp trên mọi tác nhân và ứng dụng.
- 2.Hầu hết các nhóm bắt đầu bằng cách kết nối trực tiếp các tác nhân tới cơ sở dữ liệu và API mà không có cổng chia sẻ nào như máy chủ Giao thức bối cảnh mô hình (MCP) ở giữa.
- 3.Mỗi tập dữ liệu mới yêu cầu mã tùy chỉnh và mỗi tác nhân thực hiện lại quyền kiểm soát truy cập của riêng mình.
Các tổ chức xây dựng ứng dụng được hỗ trợ bởi trí tuệ nhân tạo (AI) phải đối mặt với một thách thức thường xuyên: cấp cho các tác nhân mô hình ngôn ngữ lớn (LLM) quyền truy cập vào các hồ dữ liệu doanh nghiệp mà không trùng lặp logic tích hợp trên mọi tác nhân và ứng dụng. Hầu hết các nhóm bắt đầu bằng cách kết nối trực tiếp các tác nhân tới cơ sở dữ liệu và API mà không có cổng chia sẻ nào như máy chủ Giao thức bối cảnh mô hình (MCP) ở giữa. Mỗi tập dữ liệu mới yêu cầu mã tùy chỉnh và mỗi tác nhân thực hiện lại quyền kiểm soát truy cập của riêng mình. Khi số lượng tập dữ liệu hoặc tác nhân tăng lên, việc thực thi quyền sẽ bị thay đổi và việc đưa nguồn dữ liệu mới trở thành một nỗ lực kỹ thuật kéo dài nhiều ngày. Nhóm của chúng tôi hỗ trợ mạng lưới Trung tâm sắp xếp Bắc Mỹ (NASC) của Amazon, nơi các nhóm lập kế hoạch dựa vào dữ liệu vận hành để quản lý năng lực, nhân công và luồng gói hàng. Để cung cấp cho các nhóm đó quyền truy cập đàm thoại vào dữ liệu đó, chúng tôi đã xây dựng máy chủ Giao thức bối cảnh mô hình (MCP) không có máy chủ trên Amazon Elastic Container Service (Amazon ECS) với AWS Fargate để giải quyết vấn đề này cho các nhóm lập kế hoạch trong NASC. Máy chủ hoạt động như một cổng tập trung, không phân biệt tác nhân giữa các tác nhân AI và hồ dữ liệu doanh nghiệp của chúng tôi. Việc hiển thị tập dữ liệu mới chỉ yêu cầu tệp siêu dữ liệu JSON mà máy chủ tự động phát hiện trong lần đồng bộ hóa quy trình tiếp theo. Trong bài đăng này, chúng tôi mô tả kiến trúc, trình bày cách tiếp cận dựa trên siêu dữ liệu loại bỏ nhu cầu về mã tích hợp trên mỗi tập dữ liệu và giải thích cách cơ sở hạ tầng không có máy chủ hỗ trợ nhiều tác nhân và ứng dụng trong môi trường nhiều người thuê. Tuyên bố vấn đề và mục tiêu thiết kế Hai thách thức liên quan đến nhau đã định hình cách chúng tôi thiết kế hệ thống này: mô hình truy cập dữ liệu phân mảnh và mô hình triển khai không bền vững. Thách thức hội nhập ở quy mô Hồ dữ liệu của chúng tôi chứa hàng nghìn bộ dữ liệu bao gồm các số liệu hoạt động, phân tích kinh doanh và dữ liệu theo miền cụ thể. Nhiều nhóm muốn có trợ lý AI có thể truy vấn dữ liệu này một cách đàm thoại, nhưng mỗi nhóm đều xây dựng công cụ tích hợp riêng ngay từ đầu. Mỗi tác nhân nhúng logic tạo SQL, kiến thức lược đồ và xử lý kết nối của riêng mình, do đó, thay đổi lược đồ có nghĩa là phải vá từng tác nhân riêng lẻ. Kiểm soát quyền truy cập bị phân mảnh, không có điểm kiểm tra duy nhất cho các quyết định truy cập dữ liệu. Việc triển khai một tập dữ liệu mới yêu cầu mã công cụ tùy chỉnh, xác thực truy vấn và triển khai lại, thường là nỗ lực nhiều ngày cho mỗi bảng. Mục tiêu thiết kế Chúng tôi thiết lập bốn yêu cầu:
Truy cập hồ dữ liệu theo cấu hình. Việc thêm tập dữ liệu chỉ yêu cầu tệp siêu dữ liệu chứ không phải mã. Giao diện công cụ bất khả tri. Bất kỳ máy khách nào tương thích với MCP đều có thể gọi các công cụ tương tự. Thực thi quyền tập trung. Kiểm soát truy cập được thực thi ở lớp máy chủ MCP. Cơ sở hạ tầng đàn hồi. Hệ thống mở rộng theo mô hình khối lượng công việc AI bùng nổ.
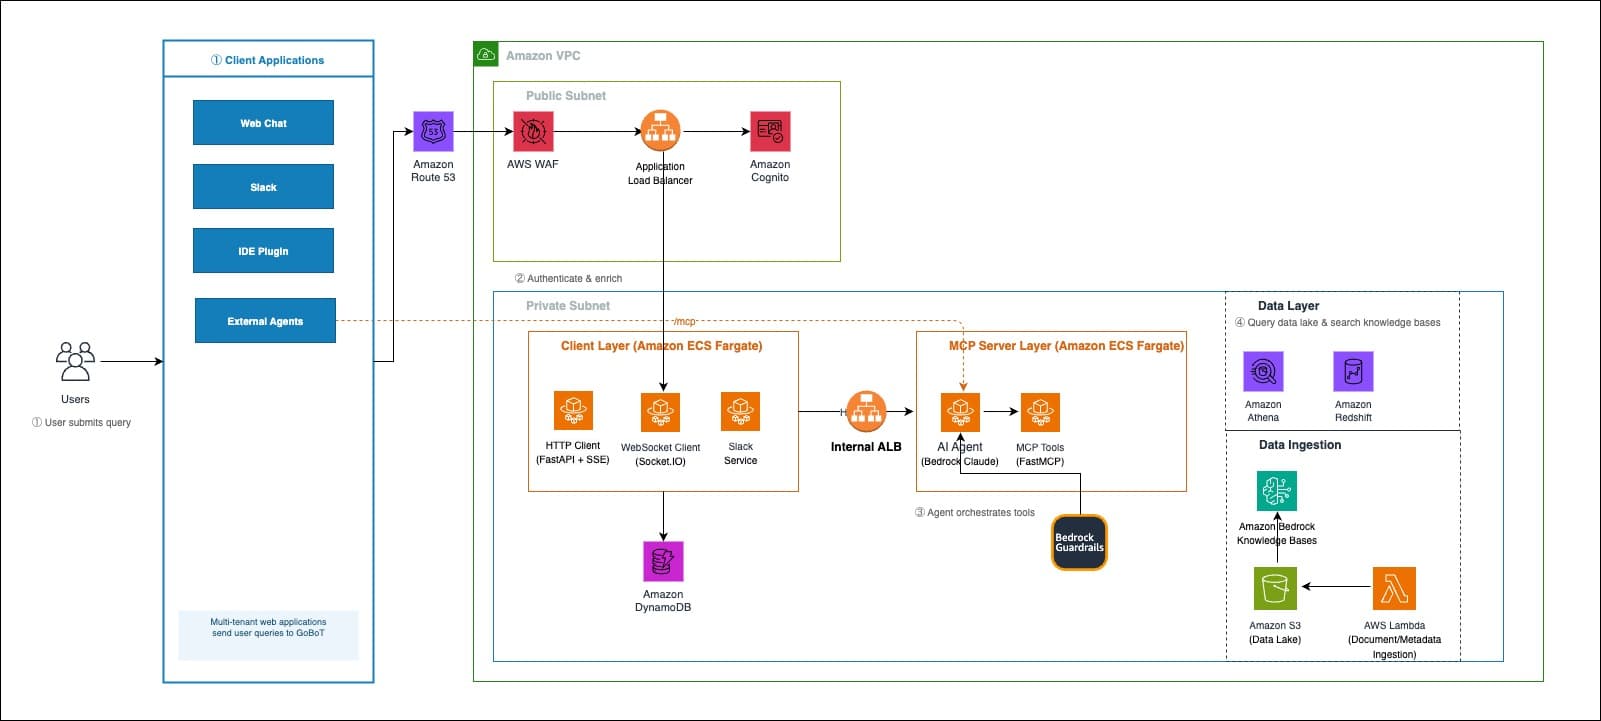
Tổng quan về giải pháp Kiến trúc chia các mối quan tâm thành bốn lớp (máy khách, máy chủ MCP, công cụ và làm mới cơ sở kiến thức), mỗi lớp có thể mở rộng và triển khai độc lập. Danh mục siêu dữ liệu làm nền tảng cho lớp công cụ, lưu trữ các mô tả lược đồ, ngữ nghĩa cấp độ cột và các mối quan hệ bảng mà tác nhân AI tham chiếu khi tạo SQL. Bởi vì tác nhân lấy được kiến thức lược đồ từ danh mục tại thời điểm truy vấn nên không cần mã hóa cấu trúc bảng hoặc triển khai lại khi lược đồ thay đổi. Lớp làm mới cơ sở kiến thức giữ cho danh mục đó luôn cập nhật, lập chỉ mục siêu dữ liệu tập dữ liệu mới khi nó xuất hiện. Các phần sau đây mô tả chi tiết từng lớp. Hướng dẫn kiến trúc Sơ đồ sau đây hiển thị luồng yêu cầu từ truy vấn của người dùng đến lớp dữ liệu trên cả bốn lớp. Người dùng gửi truy vấn từ ứng dụng khách (trò chuyện trên web, Slack, plugin IDE hoặc tác nhân bên ngoài). Yêu cầu được giải quyết thông qua Amazon Route 53 dành cho DNS và đến Cân bằng tải ứng dụng trong mạng con công cộng, được định cấu hình bằng HTTPS và AWS WAF. Bộ cân bằng tải định tuyến đến Amazon Cognito để xác thực người dùng và làm phong phú thêm yêu cầu. Sau đó, lưu lượng được xác thực sẽ đi vào mạng con riêng tư, nơi lớp máy khách chạy trên Amazon ECS Fargate. Lớp này xử lý trạng thái phiên trong Amazon DynamoDB và chuyển tiếp các yêu cầu thông qua Cân bằng tải ứng dụng nội bộ tới lớp máy chủ MCP, cũng trên Amazon ECS Fargate. Trong lớp máy chủ MCP, một tác nhân AI được hỗ trợ bởi Amazon Bedrock điều phối các công cụ được xây dựng bằng FastMCP (một khung Python để xây dựng máy chủ MCP). Amazon Bedrock Guardrails được áp dụng cho mọi tương tác mô hình. Ở bên phải, lớp dữ liệu chứa các phần phụ trợ của công cụ. Amazon Athena và Amazon Redshift chạy các truy vấn SQL dựa trên hồ dữ liệu và Cơ sở tri thức Amazon Bedrock, khả năng Tạo tăng cường truy xuất (RAG) được quản lý hoàn toàn, xử lý tìm kiếm ngữ nghĩa. Việc nhập dữ liệu vào Amazon Simple Storage Service (Amazon S3) và cơ sở kiến thức được xử lý bởi AWS Lambda. Mỗi lớp được mô tả chi tiết trong các phần tiếp theo.
Hình 1: Luồng yêu cầu thông qua máy chủ MCP serverless, từ ứng dụng khách đến lớp dữ liệu
Lớp máy khách MCP: Xác thực và quản lý phiên Một yêu cầu chuyển từ ứng dụng khách thông qua Amazon Route 53 để phân giải DNS tới Cân bằng tải ứng dụng được định cấu hình bằng HTTPS và AWS WAF. Bộ cân bằng tải chuyển tiếp lưu lượng truy cập đến dịch vụ máy khách Amazon ECS Fargate, dịch vụ này tích hợp với Amazon Cognito để xác thực JSON Web Token (JWT) và Amazon DynamoDB để lưu trữ phiên. Cấu hình ánh xạ ngữ cảnh thúc đẩy việc làm phong phú này, chỉ đưa từng truy vấn vào các bảng có liên quan. Trong thử nghiệm của chúng tôi, phạm vi này giữ độ trễ tương tác giữa hai đầu trong phạm vi 15–20 giây. Ví dụ sau đây cho thấy cấu hình ánh xạ ngữ cảnh:
{ "gói_data": { "description": "Thông tin theo dõi gói hàng và giao hàng", "bảng": ["analytics_db.khu vực_order_tóm tắt", "hoạt động_gold.load_tóm tắt"], "nguồn": {"wiki": [], "quip": []} }, "lao động_kế hoạch": { "description": "Quản lý lực lượng lao động và lập kế hoạch năng lực", "bảng": ["workforce.capacity_details"], "nguồn": {"wiki": [], "quip": []} } }
Khi ngữ cảnh chỉ định các bảng, máy chủ MCP sẽ thu hẹp tìm kiếm danh mục siêu dữ liệu vào các bảng đó, giảm nhiễu và cải thiện độ chính xác của việc tạo SQL. Việc thêm miền doanh nghiệp mới chỉ yêu cầu thêm mục nhập vào ánh xạ này. Lớp máy chủ MCP: Thực thi không trạng thái với trạng thái hội thoại Máy chủ MCP chạy trên cụm Fargate ECS của riêng nó, tách biệt với lớp máy khách. Các yêu cầu được tiếp cận thông qua Amazon Route 53 và Trình cân bằng tải ứng dụng nội bộ trong mạng con riêng tư. Máy chủ xử lý toàn bộ việc điều phối bao gồm phân tích truy vấn, lựa chọn công cụ, thực thi và tạo phản hồi. Thông qua điểm cuối giao thức MCP (/mcp), giao diện JSON-RPC được hỗ trợ bởi FastMCP, các máy khách tương thích MCP bên ngoài như Amazon Q Developer hoặc tiện ích mở rộng IDE có thể khám phá và gọi trực tiếp các công cụ. Các tác vụ Fargate không có trạng thái với trạng thái hội thoại vẫn tồn tại trong DynamoDB, do đó, các tác vụ có thể được thay thế hoặc thay đổi quy mô mà không mất dữ liệu. Khi có yêu cầu đến, tổng đài viên sẽ truy xuất lịch sử phiên, phân tích ý định của người dùng bằng cách sử dụng Amazon Bedrock, khám phá và gọi các công cụ thích hợp cũng như truyền kết quả trở lại cho người dùng. Quyền truy cập vào hồ dữ liệu dựa trên siêu dữ liệu và lớp công cụ Mỗi công cụ được đăng ký với FastMCP và có thể phát hiện được trong thời gian chạy:
Sr.không Công cụ Phần phụ trợ Mục đích
1 Công cụ truy vấn SQL Amazon Athena Amazon Dịch chuyển đỏ Truy vấn SQL đối với bất kỳ tập dữ liệu nào được định cấu hình trong kho dữ liệu và Redshift
2 Tìm kiếm tài liệu và siêu dữ liệu Cơ sở kiến thức về Amazon Bedrock Tìm kiếm ngữ nghĩa trên tài liệu nội bộ, siêu dữ liệu bảng và wiki nhóm
3 Tìm kiếm chính sách Cơ sở kiến thức về Amazon Bedrock Tìm kiếm chính sách hoạt động và quy trình chuẩn
Các công cụ truy vấn Athena là giao diện chính của hồ dữ liệu. Trước tiên, tác nhân truy vấn danh mục siêu dữ liệu để hiểu các lược đồ có sẵn, tạo truy vấn SQL được tối ưu hóa thông qua Amazon Bedrock, xác thực và tự động sửa SQL để tương thích với Athena, sau đó thực thi truy vấn đó. Kết quả sẽ quay trở lại tác nhân điều phối để tổng hợp ngôn ngữ tự nhiên. Kiểm soát AI có trách nhiệm Amazon Bedrock Guardrails được áp dụng cho tất cả các tương tác LLM và được thiết kế để lọc nội dung có hại, thực thi các biện pháp kiểm tra nền tảng và giúp chặn các nỗ lực chèn nhanh. Các biện pháp bảo vệ này hoạt động như các biện pháp kiểm soát sản xuất ở lớp máy chủ MCP, vì vậy mọi tác nhân được kết nối đều được hưởng lợi từ các chính sách an toàn nội dung giống nhau bất kể nó kết nối như thế nào. Các công cụ truy vấn Athena thực thi các truy vấn chỉ CHỌN, từ chối các thao tác ghi ở cấp công cụ trước khi chúng tiếp cận hồ dữ liệu. Lớp làm mới cơ sở kiến thức: Tích hợp tập dữ liệu bằng một tệp JSON duy nhất Toàn bộ hệ thống được xây dựng dựa trên khả năng mở rộng theo cấu hình. Việc thêm tập dữ liệu mới yêu cầu tệp JSON siêu dữ liệu mô tả bảng và mục ánh xạ ngữ cảnh tùy chọn. Tệp này ghi lại lược đồ, bối cảnh nghiệp vụ và ngữ nghĩa cấp cột của bảng. Nó đóng vai trò là nguồn thông tin duy nhất mà tác nhân AI sử dụng để hiểu và truy vấn tập dữ liệu:
{ "database_service_name": "athena", "database_name": "analytics_db", "table_name": "khu vực_order_tóm tắt", "business_description_for_the_table": "Lịch sử đặt hàng theo khu vực với trạng thái vận chuyển và hiệu suất giao hàng. Chứa các đơn hàng đã hoàn thành cùng với dữ liệu giao hàng. Làm mới hàng ngày. Trong Athena SQL, luôn sử dụng date() để bọc chuỗi ký tự khi so sánh với các cột dấu thời gian.", "cột_details": { "order_id [varchar]": { "description": "Mã định danh đơn hàng duy nhất được chỉ định khi thanh toán.", "sample_values": ["ORD-20250115-001234", "ORD-20250116-005678"] }, "ngày_đặt_hàng [dấu thời gian(3)]": { "description": "Ngày và giờ đặt hàng. Sử dụng cột này để lọc theo phạm vi thời gian.", "sample_values": ["2025-01-15 08:00:00.000", "2025-01-16 12:30:00.000"] }, "kho_id [varchar]": { "description": "Trung tâm xử lý đơn hàng.", "sample_values": ["FC-EAST-07", "FC-WEST-03", "FC-SOUTH-12"] } }, "load_type": "Tăng dần (làm mới 7 ngày qua)", "refresh_ Frequency": "Hàng ngày lúc 6:00 sáng UTC", "table_size": "~2,1B hàng", "creation_time": "2024-03-15", "last_refresh_time": "2025-05-20T06:00:00Z" }
Trường business_description_for_the_table chứa các gợi ý truy vấn dành riêng cho công cụ, chẳng hạn như “luôn sử dụng date() để bọc các chuỗi ký tự” giúp giảm lỗi xác thực SQL. Trường cột_details ghép nối mỗi tên cột [loại] với mô tả ngôn ngữ tự nhiên và các giá trị mẫu, mang lại cho tác nhân cả nhận thức về lược đồ và ngữ nghĩa kinh doanh. Trường sample_values đóng vai trò quan trọng trong việc tạo mệnh đề WHERE chính xác vì tác nhân tìm hiểu các mẫu dữ liệu thực, ví dụ: Warehouse_id giữ các mã như FC-EAST-07 thay vì các tên đánh vần như “Cơ sở khu vực phía Đông”. Quy trình chọn các tệp siêu dữ liệu, tạo các tệp nhúng vectơ bằng tính năng nhúng văn bản Amazon Titan và lập chỉ mục chúng vào Cơ sở kiến thức Amazon Bedrock. Sau khi được lập chỉ mục, tất cả các tác nhân được kết nối có thể phát hiện được bảng mà không cần lập chỉ mục lại thủ công hoặc khởi động lại máy chủ. Để cải thiện độ chính xác cho các ứng dụng cụ thể, kỹ sư có thể tùy ý liên kết tập dữ liệu với bối cảnh kinh doanh. Điều này thu hẹp phạm vi tìm kiếm, do đó tác nhân ưu tiên các bảng phù hợp. Ví dụ sau đây hiển thị mục ánh xạ ngữ cảnh:
{ "delivery_metrics": { "description": "Dữ liệu phân bổ lỗi và độ chính xác khi phân phối", "bảng": ["analytics_db.customer_orders_summary"], "nguồn": {"wiki": [], "quip": []} } }
Nếu không có ngữ cảnh nào được chỉ định, tác nhân sẽ tìm kiếm trên tất cả các bảng được lập chỉ mục. Ánh xạ ngữ cảnh giúp giảm độ trễ và cải thiện độ chính xác của SQL bằng cách giới hạn không gian tìm kiếm. Phạm vi này là tùy chọn và có thể được thêm vào bất kỳ lúc nào mà không cần sửa đổi các tệp siêu dữ liệu. Kết hợp chúng lại với nhau: Một truy vấn đang hoạt động Khi người dùng hỏi: “10 đơn hàng có giá trị cao nhất trong tháng trước của chúng tôi là gì?”, khách hàng sẽ làm phong phú thêm yêu cầu bằng bối cảnh kinh doanh để thu hẹp phạm vi. Nhân viên hỗ trợ chuyển đổi câu hỏi thành dạng nhúng vectơ, tìm kiếm danh mục siêu dữ liệu để tìm các lược đồ phù hợp và chọn bảng phù hợp nhất thông qua lệnh gọi LLM nhẹ. Bằng cách sử dụng lược đồ đã chọn, mô tả cột và gợi ý truy vấn dành riêng cho công cụ, tác nhân sẽ tạo một câu lệnh SQL như:
CHỌN order_id, customer_id, tổng_số tiền, order_date TỪ phân tích_db.khu vực_order_summary Ở ĐÂU order_date >= date_add('tháng', -1, current_date) ĐẶT HÀNG THEO tổng_số tiền DESC GIỚI HẠN 10
SQL được xác thực và tự động sửa để tương thích với công cụ, sau đó được thực thi trên Amazon Athena. Tác nhân định dạng kết quả thành phản hồi bằng ngôn ngữ tự nhiên và truyền lại cho người dùng. Trong thử nghiệm của chúng tôi, luồng từ đầu đến cuối này hoàn thành trong vòng 15–20 giây. Sự phối hợp tương tự mở rộng ra ngoài SQL thuần túy. Vì tìm kiếm tài liệu được đăng ký dưới dạng một công cụ khác trên cùng một máy chủ nên nhân viên hỗ trợ có thể trả lời các câu hỏi trải rộng trên các nguồn có cấu trúc và không cấu trúc trong một lượt, chẳng hạn như “Tỷ lệ hoàn vốn của chúng tôi cho Q4 là bao nhiêu và phân tích của nhóm sản phẩm nói gì về nguyên nhân gốc rễ?” Đối với yêu cầu đó, tổng đài viên chạy truy vấn Athena để tìm số liệu tỷ lệ hoàn trả và tìm kiếm tài liệu Cơ sở Kiến thức để phân tích, sau đó kết hợp cả hai thành một phản hồi. Bảo mật và truy cập nhiều người thuê Việc điều phối một lượt đó chỉ hoạt động vì mọi lệnh gọi công cụ đều đi qua cùng một cổng được kiểm soát. Kiến trúc sử dụng bảo mật nhiều lớp thay vì một điểm thực thi duy nhất. Máy chủ MCP chạy trong các mạng con riêng tư đằng sau Cân bằng tải ứng dụng nội bộ và không thể truy cập được từ Internet. Chỉ lớp máy khách, nằm phía sau Bộ cân bằng tải ứng dụng công khai với AWS WAF, mới có thể định tuyến các yêu cầu tới lớp đó. Amazon Cognito xác thực danh tính người dùng ở lớp máy khách và chỉ những yêu cầu mang mã thông báo đã được xác thực mới được chuyển tiếp xuống. Ở cấp độ công cụ, công cụ truy vấn Athena thực thi các truy vấn chỉ CHỌN, từ chối các thao tác ghi trước khi chúng đến hồ dữ liệu. Tất cả các lệnh gọi công cụ đều được ghi vào Amazon CloudWatch bằng JSON có cấu trúc, cung cấp cho các nhóm bảo mật một điểm kiểm tra duy nhất để truy cập dữ liệu trên mọi tác nhân và ứng dụng. Kiến trúc này có sẵn ở các Khu vực AWS nơi có sẵn Cơ sở tri thức Amazon Bedrock và Amazon Bedrock. Thiết kế tập trung này cũng là điều khiến máy chủ có nhiều người thuê. Bởi vì điểm cuối /mcp được tiêu chuẩn hóa chấp nhận bất kỳ máy khách tương thích MCP nào bất kể LLM hoặc khung điều phối nào nó sử dụng, nhiều tác nhân chia sẻ cùng một công cụ và cùng các biện pháp kiểm soát truy cập. Việc thêm một tác nhân mới chỉ yêu cầu trỏ tác nhân đó vào điểm cuối của máy chủ, do đó, việc đưa tác nhân khác vào sẽ mở rộng hệ thống mà không làm suy yếu hoặc sao chép mô hình bảo mật. Cơ sở hạ tầng và quy mô không có máy chủ Mỗi lớp mở rộng quy mô thông qua một cơ chế phù hợp với mẫu khối lượng công việc của nó:
Lớp Cơ chế mở rộng quy mô Trình kích hoạt
Khách hàng (ECS Fargate) Dịch vụ ECS Auto Scaling Mức sử dụng CPU (ngưỡng 50%)
Máy chủ MCP (ECS Fargate) Dịch vụ ECS Auto Scaling Sử dụng CPU/bộ nhớ
Athena Không có máy chủ (tự động) Truy vấn đồng thời
Đá nền Amazon Quản lý mở rộng quy mô dịch vụ Yêu cầu suy luận
Amazon ECS Fargate cung cấp khả năng điện toán phi máy chủ mà không cần quản lý phiên bản EC2. Các dịch vụ hạ nguồn (Athena, Bedrock) tự động mở rộng quy mô, do đó hệ thống xử lý một truy vấn duy nhất hoặc hàng trăm truy vấn đồng thời mà không cần thay đổi cấu hình. Các trường hợp sử dụng và tiện ích mở rộng Kiến trúc này hỗ trợ một số mẫu ngoài việc trả lời câu hỏi cơ bản. Trợ lý kiến thức doanh nghiệp có thể kết hợp truy vấn hồ dữ liệu với tìm kiếm tài liệu để trả lời các câu hỏi phức tạp bao gồm cả dữ liệu có cấu trúc và kiến thức phi cấu trúc, chẳng hạn như “Tỷ lệ hoàn vốn của chúng tôi cho Q4 là bao nhiêu và phân tích của nhóm sản phẩm nói gì về nguyên nhân gốc rễ?” Các phi công phân tích nội bộ cho phép người dùng doanh nghiệp truy vấn hồ dữ liệu một cách trò chuyện mà không cần viết SQL, dựa vào mô tả siêu dữ liệu và gợi ý truy vấn để hướng dẫn tác nhân hướng tới các mẫu truy vấn chính xác, hiệu quả. Điểm cuối /mcp được tiêu chuẩn hóa cũng hỗ trợ quy trình làm việc của nhiều tác nhân. Nhiều tác nhân chuyên biệt để phân tích dữ liệu, truy xuất tài liệu và cảnh báo vận hành có thể chia sẻ cùng một máy chủ MCP, mỗi tác nhân truy cập vào bộ công cụ đầy đủ thông qua một giao thức chung. Việc đưa dữ liệu của nhóm mới vào theo cùng một mẫu định hướng cấu hình. Họ thêm tệp JSON siêu dữ liệu và trong một chu kỳ đồng bộ hóa quy trình, mọi tác nhân và ứng dụng được kết nối đều có thể khám phá tập dữ liệu của họ. Kết luận Máy chủ MCP tập trung trên Amazon ECS Fargate cung cấp một cổng an toàn, có thể mở rộng giữa các tác nhân AI và hồ dữ liệu doanh nghiệp. Cách tiếp cận dựa trên siêu dữ liệu sẽ loại bỏ nhu cầu về mã tích hợp cho mỗi tập dữ liệu và tiêu chuẩn Giao thức bối cảnh mô hình có nghĩa là mọi máy khách tương thích MCP đều có thể kết nối mà không cần bộ điều hợp tùy chỉnh. Quyết định kiến trúc quan trọng là tách lớp công cụ khỏi lớp tác nhân. Tác nhân phát triển nhanh chóng nhưng các mẫu truy cập dữ liệu sẽ tồn tại lâu hơn bất kỳ hoạt động triển khai tác nhân đơn lẻ nào. Việc coi khả năng mở rộng là vấn đề về cấu hình thay vì vấn đề về mã sẽ giúp tăng tốc quá trình triển khai. Để tìm hiểu thêm, hãy xem Amazon ECS trên AWS Fargate, Amazon Bedrock, Amazon Bed hướng dẫn sử dụng Cơ sở Kiến thức rock, Amazon Athena và đặc tả Giao thức bối cảnh mô hình. Các bước tiếp theo Chúng tôi đang mở rộng kiến trúc này theo hai hướng. Đầu tiên, kiểm soát truy cập chi tiết hơn trong đó chủ sở hữu bảng có thể đánh dấu các cột nhạy cảm là bị hạn chế theo nhóm quyền và tác nhân tự động loại trừ các cột đó khỏi SQL được tạo mà không cần thay đổi ở cấp độ lời nhắc. Thứ hai, đóng vòng phản hồi để khi truy vấn không thành công hoặc tạo ra kết quả có độ tin cậy thấp, hệ thống sẽ nắm bắt kiểu lỗi và đưa ra các đề xuất có mục tiêu nhằm cải thiện mô tả cột, thêm gợi ý truy vấn.
Về các tác giả
Bản quyền & Xuất xứ thông tin
Bài viết này được tổng hợp và phân tích AI từ ấn phẩm AWS Machine Learning Blog. Mọi bản quyền nội dung thuộc về tác giả và toà soạn gốc.