Amazon SageMaker AI tự động phát hiện độ trễ và GPU nhàn rỗi
Tóm lược nhanh
“Amazon SageMaker AI triển khai tính năng tự động theo dõi các điểm cuối suy luận tạo sinh...”
Ý chính
- 1.Hệ thống tự động theo dõi các điểm cuối suy luận sử dụng bộ chứa vLLM và GPU theo mặc định mà không cần thiết lập ban đầu.
- 2.Công cụ phân tích ba loại tín hiệu vận hành gồm độ trễ, mức sử dụng GPU và cấu hình phục vụ của điểm cuối mà không đọc dữ liệu yêu cầu hay phản hồi.
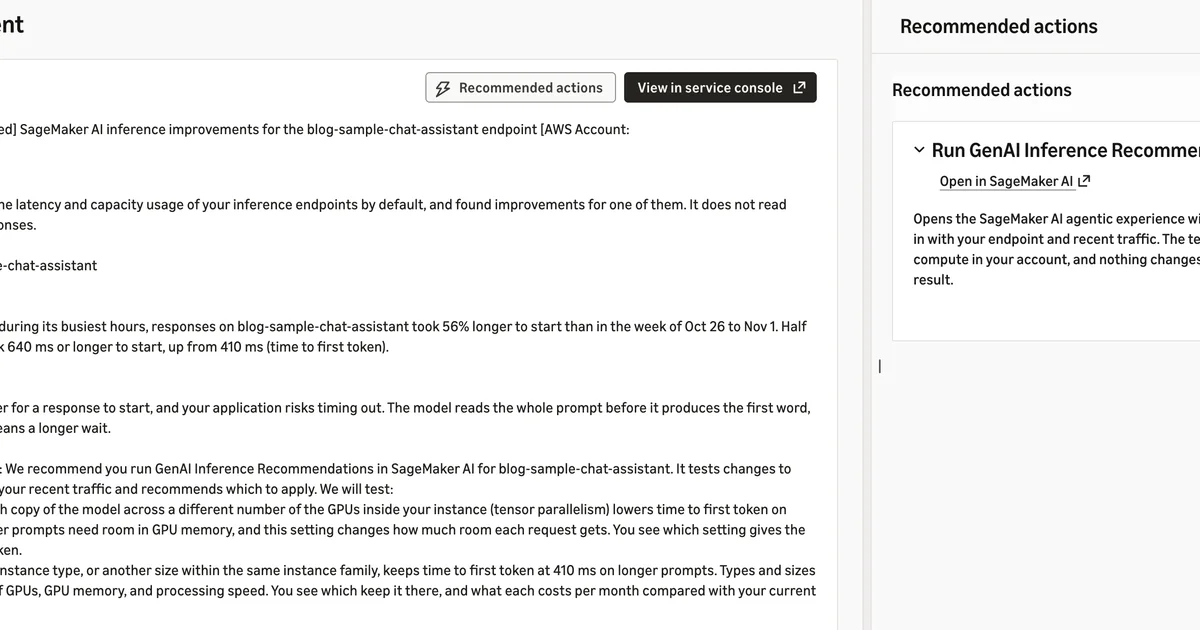
- 3.Khi phát hiện vấn đề, dịch vụ gửi thông báo qua AWS Health kèm theo liên kết mở trải nghiệm tác nhân trong Amazon SageMaker Studio để chạy thử nghiệm chuẩn hóa.
Amazon SageMaker AI triển khai tính năng tự động theo dõi các điểm cuối suy luận tạo sinh để phát hiện độ trễ tăng dần, thiết bị nhàn rỗi và các cấu hình tối ưu chưa được kích hoạt. Hệ thống này hoạt động ngầm mà không đọc nội dung yêu cầu của người dùng.
Thông tin trọng tâm & Diễn biến chính
Hệ thống tự động theo dõi các điểm cuối suy luận sử dụng bộ chứa vLLM và GPU theo mặc định mà không cần thiết lập ban đầu.
Công cụ phân tích ba loại tín hiệu vận hành gồm độ trễ, mức sử dụng GPU và cấu hình phục vụ của điểm cuối mà không đọc dữ liệu yêu cầu hay phản hồi.
Khi phát hiện vấn đề, dịch vụ gửi thông báo qua AWS Health kèm theo liên kết mở trải nghiệm tác nhân trong Amazon SageMaker Studio để chạy thử nghiệm chuẩn hóa.
Phân tích chuyên sâu & Tác động
Việc chuyển đổi quá trình tối ưu hóa từ đánh giá thủ công sang giám sát tự động giúp các đội ngũ kỹ thuật duy trì hiệu suất mô hình khi khối lượng công việc và độ dài prompt thay đổi theo thời gian.
Cơ chế cách ly thử nghiệm trên các tài nguyên tính toán riêng biệt giúp loại bỏ rủi ro khi kiểm tra các cấu hình thay thế trước khi áp dụng vào môi trường sản xuất thực tế.
Triển vọng & Các yếu tố cần theo dõi
Phản hồi chi tiết về chi phí vận hành thực tế và mức độ tiêu thụ tài nguyên của các tác vụ thử nghiệm chuẩn hóa trên quy mô lớn chưa được làm rõ đầy đủ.