SageMaker Inference hiện hỗ trợ GPU đa phiên bản để tối đa hóa mức sử dụng GPU cho các điểm cuối của mô hình
Tóm lược nhanh
Tổng hợp và đối chiếu bởi gemini-2.0-flash-thinking-exp
“Khi bạn triển khai một mô hình tới điểm cuối GPU, đơn vị GPU nhỏ nhất bạn có thể yêu cầu là toàn bộ”
Các điểm cốt lõi
- 1.Khi bạn triển khai một mô hình tới điểm cuối GPU, đơn vị GPU nhỏ nhất bạn có thể yêu cầu là toàn bộ một bộ tăng tốc.
- 2.Hạn chế này có thể khiến bạn phải trả giá gấp đôi.
- 3.Đầu tiên, bạn không thể lưu trữ nhiều mô hình trên một phiên bản hơn số lượng mô hình mà nó có.
Khi bạn triển khai một mô hình tới điểm cuối GPU, đơn vị GPU nhỏ nhất bạn có thể yêu cầu là toàn bộ một bộ tăng tốc. Hạn chế này có thể khiến bạn phải trả giá gấp đôi. Đầu tiên, bạn không thể lưu trữ nhiều mô hình trên một phiên bản hơn số lượng mô hình mà nó có. Một ml.p4d.24xlarge có tám chiếc A100, do đó, nó chứa được tám mẫu, cho dù mỗi mẫu cần 40 GB hay 14 GB. Thứ hai, và ít rõ ràng hơn, nó khiến mọi hoạt động triển khai đều phụ thuộc vào việc lựa chọn GPU đầy đủ để triển khai. Khi thời gian xử lý đồng thời và lời nhắc của bạn tăng lên, GPU đầy đủ trên phiên bản cũ hơn sẽ không còn đủ nữa, nhưng GPU đầy đủ trên phiên bản mới hơn sẽ nhiều hơn mức mà mô hình của bạn có thể sử dụng. Cuối cùng, bạn không được phục vụ đủ mức hoặc phải trả tiền cho khả năng mà bạn không bao giờ đạt tới. Hiện nay, Amazon SageMaker Inference hỗ trợ phân vùng GPU, sử dụng GPU đa phiên bản NVIDIA (MIG) để chia GPU vật lý thành các phân vùng độc lập. Mỗi phân vùng nhận được một phần cố định các đơn vị tính toán của GPU và một khối bộ nhớ chuyên dụng, với sự cách ly được thực thi trong phần cứng. Điều đó thay đổi cả hai ràng buộc: bạn có thể đặt một mô hình khác nhau trong mỗi phân vùng và bạn có thể chọn một phần của bộ tăng tốc mới hơn thay vì toàn bộ một trong hai thế hệ. Bài đăng này bao gồm cả hai. Phần đầu tiên là lợi ích trực tiếp: triển khai nhiều mô hình hơn số GPU bạn có, với sự tách biệt giữa chúng. Thứ hai là câu hỏi mà khách hàng hỏi khi chuyển sang câu hỏi về chi phí: mức độ chi tiết của việc phân vùng giúp bạn chọn đơn vị có kích thước phù hợp như thế nào và những gì chúng tôi đã đo được khi thực hiện. Một điều cần biết trước khi bạn đọc thêm: Phân vùng GPU hoạt động trên các điểm cuối sử dụng các thành phần suy luận, cấu trúc bạn sử dụng để triển khai một số mô hình cho một điểm cuối và đặt khả năng tính toán cho từng mô hình. Phân vùng được xây dựng trực tiếp trên đó. Phân vùng là tài nguyên mà một thành phần yêu cầu, ở cùng một nơi nó đã yêu cầu CPU và bộ nhớ. Nếu bạn chưa sử dụng các thành phần suy luận, bài đăng này sẽ giới thiệu chúng. Không thể phân vùng các điểm cuối mô hình đơn, điểm cuối không có máy chủ và nhóm phiên bản không đồng nhất. Những gì khách hàng làm ngày hôm nay, một d tại sao mỗi lựa chọn đều thiếu Nếu bạn có nhiều mô hình hơn máy gia tốc, bạn có ba lựa chọn. Chạy ít hơn, điểm cuối lớn hơn và khó hơn theo đợt – Điều này làm tăng mức sử dụng nhưng chỉ khi các mô hình có thể hoán đổi cho nhau. Không có danh mục các biến thể được tinh chỉnh hoặc mô hình cho mỗi người thuê. Sử dụng điểm cuối nhiều mô hình – Các mô hình tải và dỡ tải này từ GPU dùng chung theo yêu cầu, phù hợp với lưu lượng truy cập thưa thớt, bùng nổ. Tuy nhiên, các mẫu máy chia sẻ thiết bị mà không bị cô lập, do đó, yêu cầu lớn đối với một mẫu máy sẽ ảnh hưởng đến các mẫu máy khác. Một mô hình không được tải cũng sẽ bị phạt khi tải vào lần sử dụng đầu tiên. Chuyển sang Kubernetes tự quản lý – Đây là nơi mà những khách hàng cần phân vùng GPU thực sự đã đến. MIG hoạt động ở đó, nhưng bạn đảm nhận việc lập phiên bản trình điều khiển, cấu hình phân vùng, plugin thiết bị, lập lịch và giữ tất cả nhất quán trong một nhóm. Đó là rất nhiều công việc đối với khả năng phần cứng mà phiên bản của bạn đã có. Tại sao MIG GPU đa phiên bản NVIDIA (MIG) chia một GPU thành tối đa bảy phiên bản, tùy thuộc vào GPU. Mỗi phiên bản có điện toán, bộ đệm, bộ nhớ và băng thông bộ nhớ riêng. Vì sự phân chia diễn ra ở phần cứng chứ không phải phần mềm nên bạn nhận được sự đảm bảo mà các phương thức chia sẻ khác không thể mang lại:
Độ trễ có thể dự đoán được – Mỗi phân vùng có băng thông bộ nhớ chuyên dụng, do đó lưu lượng truy cập tăng đột biến của một mô hình không hiển thị trong p99 của mô hình khác. Cách ly lỗi – Sự cố hoặc lỗi bộ nhớ vẫn nằm trong phân vùng của nó thay vì gỡ bỏ mọi kiểu máy trên GPU. Dung lượng vừa phải – Các mẫu máy vừa và nhỏ có một phần phù hợp với chúng thay vì toàn bộ GPU. Bạn có thể kết hợp các kích thước lát trên một thiết bị. Không khởi động nguội – Mỗi mô hình giữ phân vùng riêng và luôn được tải, không bị phạt tải và không bị trục xuất. Cách ly đối tượng thuê – Việc bảo vệ bộ nhớ giữa các phân vùng được thực thi trong phần cứng, giúp việc đánh giá tuân thủ và bảo mật trở nên đơn giản hơn. Lập kế hoạch và hoàn phí đáng tin cậy – Một phân vùng hoạt động theo cách tương tự bất kể các lân cận của nó, do đó, các thử nghiệm tải sẽ dự đoán quá trình sản xuất. Chi phí GPU cũng ánh xạ rõ ràng tới mô hình, nhóm hoặc đối tượng thuê.
Việc phân vùng có những ranh giới đáng để biết trước. Số lượng phân vùng tối đa phụ thuộc vào trình tăng tốc và không bao giờ vượt quá bảy. Bản thân MIG chỉ cho phép thay đổi bố cục khi các phân vùng của nó không hoạt động và trên SageMaker AI, điều đó có nghĩa là chọn bố cục khi bạn tạo điểm cuối. Một mô hình cần nhiều GPU vẫn cần toàn bộ thiết bị. Trong các ranh giới đó, bạn sẽ có được sự tách biệt giữa các GPU riêng biệt mà không cần dành riêng một GPU cho mỗi kiểu máy. Phân vùng mà không cần nền tảng hoạt động Cho đến thời điểm hiện tại, việc nhận MIG có nghĩa là bạn phải tự mình chạy ngăn xếp Kubernetes. Việc phân vùng GPU trên Amazon SageMaker AI sẽ loại bỏ bước đó: bạn chọn cấu hình phân vùng cho mô hình của mình và SageMaker AI sẽ xử lý cấu hình, vị trí và chia tỷ lệ GPU. Bạn nhận được tính năng chia sẻ GPU tách biệt với phần cứng trên điểm cuối được quản lý mà không cần phải chạy nền tảng bên dưới điểm cuối đó. Salesforce đã tham gia vào công việc này ngay từ đầu, giúp xác định các yêu cầu và xác thực quá trình triển khai ban đầu.
"NVIDIA MIG phân vùng một GPU thành nhiều phiên bản riêng biệt, mỗi phiên bản có tài nguyên bộ nhớ và điện toán chuyên dụng. Salesforce coi đây là một khả năng quan trọng vì nhiều khối lượng công việc suy luận không yêu cầu toàn bộ GPU. MIG sẽ cho phép chúng tôi hợp nhất khối lượng công việc một cách an toàn, cải thiện đáng kể việc sử dụng GPU, giảm chi phí suy luận và duy trì hiệu suất có thể dự đoán được cũng như khả năng cách ly mạnh mẽ. Khả năng này sẽ giúp chúng tôi mở rộng quy mô Suy luận AI hiệu quả hơn trong các trường hợp sử dụng khác nhau. Salesforce đã giúp xác định các yêu cầu, xác thực giải pháp ban đầu. Chúng tôi hiện đang chuẩn bị xác thực giải pháp với khối lượng công việc sản xuất tiêu biểu và thể hiện nhu cầu mạnh mẽ của khách hàng với AWS. Chúng tôi tin rằng sự hỗ trợ của MIG sẽ mang lại giá trị kinh doanh và kỹ thuật có ý nghĩa cho khách hàng doanh nghiệp.” — Richard Chang, Kiến trúc sư kỹ thuật phần mềm, Salesforce
Nó hoạt động như thế nào Phân vùng GPU thêm hai trường tùy chọn vào lệnh gọi API mà bạn đã thực hiện. Không có hoạt động API mới, không có loại tài nguyên mới cũng như không có hành động AWS Identity and Access Management (IAM) mới nào và một điểm cuối bỏ qua cả hai trường sẽ hoạt động chính xác như hiện nay. AcceleratorPartitionLayouts tiếp tục một biến thể sản xuất trong CreateEndpointConfig và khai báo cách phân chia từng bộ tăng tốc:
{ "EndpointConfigName": "được phân vùng theo nhiều mô hình", "ExecutionRoleArn": " ", "Biến thể sản xuất": [ { "Tên biến thể": "AllTraffic", "InstanceType": "ml.p4d.24xlarge", "Số lượng phiên bản ban đầu": 1, "AcceleratorPartitionLayouts": [ { "AcceleratorPartitionTypes": ["mig-4g.20gb", "mig-2g.10gb", "mig-1g.5gb"] } ] } ] }
Một chiếc A100 có bảy lát điện toán để phân chia. Bố cục trước đó sử dụng tất cả bảy phân vùng, do đó, mỗi phân vùng trong số tám phân vùng A100 trên phiên bản p4d mang ba phân vùng và điểm cuối cung cấp 24, tám phân vùng mỗi loại. Việc khắc được áp dụng thống nhất. Một mục bố cục mô tả cách phân chia một trình tăng tốc và mọi trình tăng tốc trên mọi phiên bản trong biến thể đều được chia theo cùng một cách. Danh sách này không có vị trí nên một mục nhập không ánh xạ tới một GPU cụ thể. AcceleratorPartitionType đi vào một thành phần suy luận và chọn phân vùng mà mô hình sẽ chạy trên đó:
{ "InferenceComponentName": "tóm tắt", "EndpointName": "được phân vùng theo nhiều mô hình", "Tên biến thể": "AllTraffic", "Thông số kỹ thuật": { "ModelName": "mô hình tóm tắt", "Yêu cầu tài nguyên máy tính": { "AcceleratorPartitionType": "mig-4g.20gb", "SốOfAcceleratorDevicesYêu cầu": 1, "SốCpuCoresYêu cầu": 1, "MinMemoryRequiredInMb": 2048 } }, "RuntimeConfig": { "CopyCount": 1 } }
Mỗi bản sao thành phần chiếm một phân vùng thuộc loại được yêu cầu. Với tám phân vùng của mỗi loại trên phiên bản, việc nâng cao CopyCount sẽ đặt các bản sao bổ sung vào các phân vùng trống. Điều này hữu ích cho một mô hình nhỏ phục vụ tính đồng thời cao, trong đó một quy trình duy nhất khiến GPU phải chờ theo yêu cầu. NumberOfAcceleratorDevicesRequired luôn là 1 ở đây. Với một loại phân vùng được đặt, nó có nghĩa là một phân vùng chứ không phải một bộ tăng tốc. NumberOfCpuCoresRequired và MinMemoryRequiredInMb vẫn mô tả CPU máy chủ và bộ nhớ máy chủ, vì bộ nhớ GPU đến từ loại phân vùng. Lời mời không thay đổi. InvokeEndpoint đánh địa chỉ một mô hình theo tên thành phần suy luận và phân vùng mà nó chiếm giữ không bao giờ xuất hiện trong yêu cầu. Việc phân vùng diễn ra trong khi điểm cuối được cung cấp. Khi nó đạt đến trạng thái InService, mọi bộ tăng tốc đều được khắc phục và các phân vùng trống, đây là trạng thái hợp lệ khi các thành phần tiếp đất trên chúng sau đó. Trong thử nghiệm của chúng tôi, bộ tăng tốc khắc đã tăng thêm khoảng 17 giây để cung cấp. Thời gian còn lại là khởi chạy phiên bản và kéo vùng chứa thông thường. Cấu hình phân vùng theo GPU Các cấu hình có sẵn cho bạn là một thuộc tính của GPU, vì vậy hãy bắt đầu bằng cách tìm hiểu loại phiên bản của bạn mang GPU nào và tra cứu nó trong các cấu hình MIG được NVIDIA hỗ trợ, đây là quyền hạn trên bộ cấu hình đầy đủ và các kết hợp hợp lệ trên một thiết bị.
Họ phiên bản Máy gia tốc bộ nhớ GPU Độ chi tiết (tính toán / bộ nhớ) Hồ sơ phân vùng có sẵn Phân vùng tối đa cho mỗi GPU
P4d NVIDIA A100 40GB 7/8 mig-1g.5gb, mig-1g.10gb (xem ghi chú trình điều khiển), mig-2g.10gb, mig-3g.20gb, mig-4g.20gb, mig-7g.40gb 7
P5 NVIDIA H100 80 GB 7/8 mig-1g.10gb, mig-1g.20gb, mig-2g.20gb, mig-3g.40gb, mig-4g.40gb, mig-7g.80gb 7
G7 NVIDIA RTX PRO 4500 Blackwell 32GB 2 / 2 mig-1g.16gb, mig-2g.32gb 2
G7e Phiên bản máy chủ NVIDIA RTX PRO 6000 Blackwell 96GB 4/4 mig-1g.24gb, mig-2g.48gb, mig-4g.96gb 4
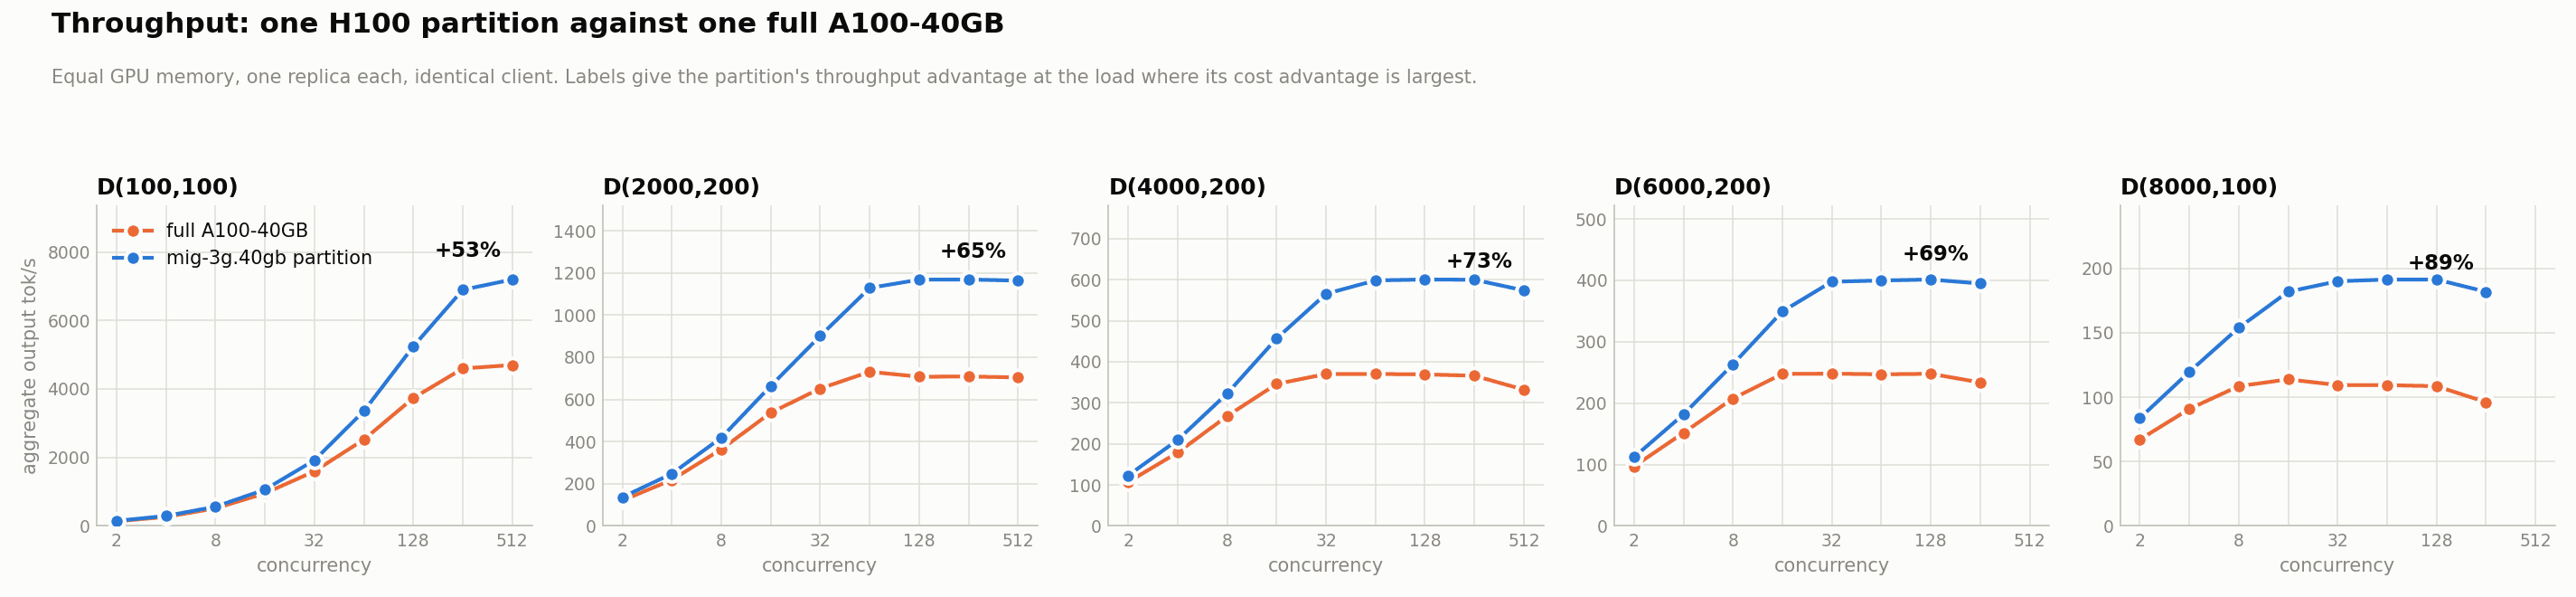
Đọc tên cấu hình dưới dạng đơn vị điện toán, theo sau là bộ nhớ GPU: mig-3g.40gb cần ba đơn vị điện toán và 40 GB. Cột chi tiết là cột giới hạn bố cục. A100 và H100 chia thành phần bảy về tính toán và phần tám về bộ nhớ, trong khi G7 chia thành hai nửa và G7e thành hai phần tư. Tên cấu hình khác nhau giữa các GPU ngay cả khi số lượng lát khớp khớp nhau, vì vậy, đừng mang bố cục từ họ phiên bản này sang họ phiên bản khác mà không kiểm tra nó dựa trên bảng này. Trong những giới hạn đó bạn có sự lựa chọn thực sự. Trên P4d hoặc P5, bạn có thể khắc bảy cấu hình nhỏ nhất hoặc hai phân vùng 3g hoặc bố cục 4g cộng 2g cộng 1g được sử dụng trong ví dụ trước hoặc lấy toàn bộ thiết bị làm một. Trên G7e, bạn có thể sử dụng bốn thiết bị nhỏ nhất hoặc hai thiết bị 1g bên cạnh một thiết bị 2g, hoặc hai thiết bị 2g hoặc toàn bộ thiết bị. Trên G7, hai phân vùng hoặc một. Cấu hình 3g là thứ cần biết vì hai chiều của nó không khớp nhau: nó chiếm ba trong số bảy đơn vị tính toán nhưng bốn trong số tám đơn vị bộ nhớ. Hai trong số chúng lấp đầy GPU và không có gì khác phù hợp bên cạnh chúng. Quy tắc cấp cao: Mỗi cấu hình trong bố cục của bạn phải là một cấu hình mà GPU của bạn cung cấp, đồng thời các đơn vị tính toán và bộ nhớ mà cấu hình của bạn thêm vào không được vượt quá những gì một thiết bị cung cấp. Cả hai đều được kiểm tra khi bạn tạo cấu hình điểm cuối và một trong hai lỗi là do bị từ chối chứ không phải là dự phòng cho toàn bộ bộ tăng tốc. Lưu ý về trình điều khiển dành cho P4d: mig-1g.10gb yêu cầu trình điều khiển NVIDIA R525 hoặc mới hơn và hình ảnh P4d mặc định có 470.256.02. Yêu cầu nó trên hình ảnh mặc định và việc khắc không thành công mà không gặp lỗi khi đặt tên hồ sơ. Đặt InferenceAmiVersion thành al2023-ami-sagemaker-inference-gpu-4-1 trên biến thể sản xuất để có được hình ảnh trên dòng trình điều khiển 580 cung cấp nó. Chọn bố cục cho khối lượng công việc của bạn Lựa chọn tốt là một câu hỏi khác với việc chọn một bố cục chỉ được chấp nhận. Một phân vùng giao cho bạn tính toán và bộ nhớ theo tỷ lệ cố định và cả hai thực hiện các công việc khác nhau trong quá trình suy luận. Đơn vị tính toán là những gì bạn cần để điền trước. Sơ lược Tôi đọc lời nhắc và xây dựng cách thể hiện nó. Đây là giai đoạn nặng về điện toán và nó thay đổi theo các bộ xử lý phát trực tuyến, đồng thời giữ lại TFLOP, phân vùng của bạn. Thông tin đầu vào của bạn càng dài và càng có nhiều lời nhắc đến cùng một lúc thì nó càng chi phối tốc độ bạn trả lại mã thông báo đầu tiên. Đơn vị bộ nhớ là thứ bạn cần để giải mã và tăng dung lượng. Việc tạo mã thông báo sẽ đọc lại trọng số mô hình ở mỗi bước, do đó việc giải mã bị giới hạn bởi băng thông bộ nhớ thay vì toán học và bộ nhớ cũng giới hạn dung lượng bộ nhớ đệm KV mà bạn có thể giữ. Giới hạn đó lần lượt đặt độ dài ngữ cảnh bạn có thể phân phát và số lượng trình tự bạn có thể phân phát đồng thời. Hầu như không có khối lượng công việc thực tế nào chỉ thực hiện một trong số này, vì vậy mục tiêu không phải là chọn thứ nguyên mà là chọn sự kết hợp hỗ trợ trường hợp sử dụng của bạn. Chọn một cấu hình có tỷ lệ bao gồm giai đoạn nặng nhất của bạn trong khi vẫn phục vụ đầy đủ cho phần còn lại. Về mặt tính toán, điều quan trọng là thời lượng lời nhắc của bạn là bao lâu và số lượng lời nhắc đến cùng một lúc. Về mặt bộ nhớ, đó là độ dài đầu ra, cửa sổ ngữ cảnh và tính đồng thời của bạn. Bộ nhớ dễ bị đánh giá thấp hơn cả hai, bởi vì một phân vùng phải chứa ba thứ chứ không chỉ mô hình: trọng lượng đối với mô hình 8B ở FP16 là khoảng 16 GB. Bộ đệm KV, có kích thước phù hợp với độ dài ngữ cảnh và số lượng trình tự đồng thời mà bạn định cho phép, đây là thuật ngữ mà mọi người bỏ qua và là thuật ngữ tăng lên cùng với lưu lượng truy cập. Và 1–2 GB chi phí thời gian chạy cho ngữ cảnh CUDA và quy trình phân phối. Hãy thêm những thứ đó trước khi chọn cấu hình, vì chỉ phân vùng có kích thước bằng trọng lượng sẽ tải mô hình và sau đó không tải được hoặc lặng lẽ phục vụ bối cảnh ngắn hơn nhiều so với bối cảnh bạn đã định cấu hình. Đối với một điểm tham chiếu cụ thể, mô hình 8B tương tự tại FP16 phục vụ thoải mái bối cảnh 8.000 mã thông báo trên phân vùng 40 GB. Nơi MIG mang lại nhiều giá trị nhất Danh mục các mô hình cỡ vừa và nhỏ – Trường hợp trực tiếp. Các biến thể được tinh chỉnh, mô hình nhúng, trình sắp xếp lại và trình phân loại mà mỗi biến thể để lại hầu hết một máy gia tốc không được sử dụng bây giờ chia sẻ một. Phân phối mô hình nhiều bên thuê – Khi bạn lưu trữ một mô hình cho mỗi khách hàng, MIG sẽ cung cấp cho bạn ranh giới phần cứng giữa chúng: một quy trình trong một phân vùng không thể đọc bộ nhớ của phân vùng khác hoặc lấy thông lượng của phân vùng đó. Tuy nhiên, hãy xác định phạm vi yêu cầu một cách chính xác. Các mô hình trên cùng một phiên bản vẫn chia sẻ CPU chủ, bộ nhớ hệ thống, bộ nhớ, kết nối mạng và định tuyến điểm cuối, do đó việc phân vùng là một cơ chế cách ly cho GPU chứ không phải là ranh giới thuê hoàn chỉnh. Quy trình nhiều giai đoạn trên một phiên bản – Mô hình phiên mã, mô hình nhật ký và mô hình ngôn ngữ hoặc trình nhúng, trình sắp xếp lại và trình tạo. Mỗi giai đoạn là một thành phần có thể định địa chỉ riêng trên phân vùng riêng của nó và bước nhảy mạng giữa các giai đoạn sẽ biến mất. Một mô hình nhỏ trong đường dẫn yêu cầu – Một mô hình phân loại an toàn hoặc mô hình lan can phải chạy theo mọi yêu cầu nhưng không thể biện minh cho bộ tăng tốc, với độ trễ có thể dự đoán được vì nó không cắt giảm thời gian so với mô hình chính. Kẻ thách thức và chim hoàng yến – Chạy mô hình ứng cử viên trên một phân vùng nhỏ bên cạnh mô hình phục vụ lưu lượng sản xuất thay vì đặt điểm cuối thứ hai. Hiệu suất: Một phần GPU mới hơn so với toàn bộ GPU cũ hơn Ngoài việc đóng gói thùng rác, lợi ích khác mà bạn nhận được là mức độ chi tiết trên GPU cao cấp: nhiều tùy chọn GPU hơn để triển khai mô hình và lựa chọn mô hình nào là của bạn. Mỗi bộ tăng tốc được hỗ trợ sẽ có nhiều kích thước thay vì một, vì vậy cách thực tế để nghĩ về nó là mỗi cấu hình là một tùy chọn GPU theo đúng nghĩa của nó, nằm cạnh toàn bộ các bộ tăng tốc mà bạn đã chọn. Điều đó quan trọng nhất khi bạn đang xem xét một loại phiên bản lớn hơn hoặc mới hơn, vì việc nâng lên không còn là tất cả hoặc không có gì: bạn có thể sử dụng GPU lớn hơn đó nhiều hay ít tùy theo nhu cầu khối lượng công việc của bạn, ở bất kỳ kích thước nào mà nó xuất bản, thay vì trả tiền cho toàn bộ chương trình tăng tốc. Để xem điều đó có hiệu quả hay không, chúng tôi đã so sánh một phân vùng mig-3g.40gb của H100 với toàn bộ phân vùng A100-40GB chưa được khắc. Hai người có sự so sánh ble bộ nhớ GPU, giúp bạn dễ dàng xem mức độ mạnh mẽ của một phiên bản nâng cao hơn. Chúng tôi đã sử dụng genai-bench để tạo tải, điều khiển cả hai điểm cuối từ cùng một máy khách nên GPU là biến duy nhất. Cả hai bên đều chạy Llama-3.1-8B-Instruct trên các điểm cuối thời gian thực SageMaker sản xuất, mỗi điểm một bản sao mô hình, với hình ảnh vùng chứa, mã thông báo và cấu hình máy khách giống hệt nhau. Cả hai đều được gọi thông qua tuyến đường tương thích với OpenAI gốc của SageMaker AI. Chúng tôi đã quét năm hình dạng lưu lượng truy cập, được viết là D (mã thông báo đầu vào, mã thông báo đầu ra) và sắp xếp từ các lời nhắc ngắn đến tóm tắt theo ngữ cảnh dài, mỗi hình dạng trên một thang đồng thời từ 2 đến 512.
Hình 1: Mã thông báo đầu ra tổng hợp mỗi giây cho một phân vùng mig-3g.40gb của H100 so với một A100-40GB đầy đủ, trên năm hình dạng lưu lượng truy cập và thang đồng thời từ 2 đến 512
Hình 2: Lợi ích chi phí phân vùng trên một triệu mã thông báo đầu ra so với đồng thời cho năm hình dạng lưu lượng truy cập giống nhau
Có bốn điều nổi bật.
Phân vùng nhanh hơn ở mọi nơi – Nó phân phối nhiều mã thông báo đầu ra hơn mỗi giây trong mọi kịch bản ở mọi thời điểm đồng thời, từ 53% đến 89% ở mức tải mà lợi ích chi phí của mỗi kịch bản là lớn nhất và độ trễ giữa các mã thông báo cũng thấp hơn trong mỗi kịch bản, từ 8,9% đến 42,1%. Khoảng cách mở rộng với tải. Thời gian nhận được mã thông báo đầu tiên thấp hơn trong mọi trường hợp, từ 5,6% đến 47,5%. Về chi phí, nó rẻ hơn 18–34% trên một triệu mã thông báo đầu ra, cao hơn mức giao nhau di chuyển sớm hơn khi lời nhắc kéo dài. Đồng thời 64 cho lời nhắc 100 mã thông báo, 4 cho lời nhắc 8.000 mã thông báo. Bên dưới chiếc crossover, toàn bộ A100 là đơn vị rẻ hơn. Các mức giá này đều theo yêu cầu, tại thời điểm phân tích được tính là 25,251286 USD/giờ đối với ml.p4d.24xlarge và 63,296000 USD/giờ đối với ml.p5,48xlarge ở Khu vực AWS Miền Tây Hoa Kỳ (Oregon). Hoàn toàn dành cho phân tích của riêng mình, chúng tôi đã tính chi phí đơn vị bằng cách chia chi phí toàn bộ phiên bản cho số đơn vị trên đó: 8 trên p4d và 16 trên p5, trong đó phân vùng của chúng tôi là một nửa GPU. Ở đầu bậc thang về lưu lượng truy cập theo ngữ cảnh dài, A100 đã ngừng phân phát. Trên cả khối lượng công việc 6.000 và 8.000 mã thông báo, nó không thành công từ một phần ba đến một nửa số yêu cầu so với thời hạn đường dẫn phân phối, trong khi phân vùng không bị lỗi. Đó là lý do tại sao hai tấm đó kết thúc sớm hơn những tấm còn lại.
Hãy coi đây là sự so sánh từng trường hợp chứ không phải là một phán quyết. Mô hình tinh thần hữu ích là coi các phân số GPU có sẵn là loại GPU theo đúng nghĩa của chúng. Liệt kê chúng cùng với toàn bộ các bộ tăng tốc, tìm hiểu xem lưu lượng truy cập của bạn thực sự yêu cầu gì về điện toán và bộ nhớ, đồng thời so sánh chúng trên khối lượng công việc của riêng bạn. Đối với lưu lượng đầu vào dài, đồng thời cao, phân vùng giành được cả hiệu suất và chi phí ở đây. Đối với khối lượng công việc đầu vào ngắn hoặc đồng thời thấp, toàn bộ A100 vẫn rẻ hơn. Phân vùng không phải là câu trả lời phù hợp cho tất cả. Nó cung cấp cho bạn nhiều kích thước hơn để lựa chọn, vì vậy bạn có thể chọn kích thước phù hợp với khối lượng công việc của mình. Những điều cần biết trước khi bạn cam kết bố cục Việc phân vùng sẽ thay đổi hình dạng của điểm cuối và bạn cần hiểu rõ một số thuộc tính trước khi thiết kế điểm cuối. Loại phân vùng của một thành phần được cố định trong suốt vòng đời của thành phần đó. Di chuyển một mô hình sang một cấu hình khác có nghĩa là tạo một thành phần mới. Việc thay đổi bản khắc của điểm cuối có nghĩa là một điểm cuối mới và di chuyển lưu lượng truy cập, vì việc cập nhật cấu hình điểm cuối sẽ không khắc lại các máy chủ đang chạy. Điều này làm cho việc phân vùng trở nên phù hợp cho danh mục đầu tư ổn định và kém phù hợp cho danh mục đầu tư mà bạn sắp xếp lại hàng ngày. Cấu hình được yêu cầu phải tồn tại trong bố cục của điểm cuối. Không có phương án dự phòng nào cho toàn bộ máy gia tốc, do đó, thành phần yêu cầu hồ sơ mà biến thể không khai báo sẽ bị từ chối. Phân vùng áp dụng cho suy luận thời gian thực trên các điểm cuối của thành phần suy luận. Các điểm cuối không có máy chủ và nhóm phiên bản không đồng nhất không được hỗ trợ và lệnh gọi không đồng bộ không thể xử lý thành phần suy luận, do đó khối lượng công việc không đồng bộ nằm ngoài phạm vi. Bạn sẽ bị tính phí cho phiên bản GPU đầy đủ như hiện tại. Việc phân vùng sẽ tăng số lượng phiên bản đó bạn có thể sử dụng. Nó không thay đổi giá hàng giờ của nó. Cuối cùng, một mô hình thực sự cần một bộ tăng tốc đầy đủ hoặc nhiều hơn một bộ tăng tốc thì nên tiếp tục có một bộ tăng tốc. Không có phân vùng mở rộng máy gia tốc. Các phiên bản và khu vực được hỗ trợ Phân vùng GPU có sẵn trên P4d, P5, G7 và G7e các gia đình mẫu. Hỗ trợ ở cấp độ gia đình, vì vậy các quy mô nhỏ hơn trong một gia đình sẽ được bảo hiểm. Dịch vụ này có sẵn ở các Khu vực AWS sau: Miền Đông Hoa Kỳ (Bắc Virginia), Miền Đông Hoa Kỳ (Ohio), Miền Tây Hoa Kỳ (Oregon), Châu Á Thái Bình Dương (Singapo), Châu Á Thái Bình Dương (Tokyo), Châu Âu (Frankfurt) và Châu Âu (Ireland). Tính sẵn có của phiên bản thay đổi theo Khu vực, vì vậy hãy xác nhận rằng loại phiên bản bạn chọn được cung cấp ở Khu vực của bạn và bạn có hạn mức sử dụng điểm cuối cho loại phiên bản đó. Bắt đầu Để phân vùng điểm cuối GPU, hãy tính toán bộ nhớ và tính toán từng nhu cầu của mô hình, chọn cấu hình phù hợp, khai báo bố cục trên cấu hình điểm cuối của bạn và triển khai từng mô hình dưới dạng thành phần suy luận yêu cầu cấu hình từ bố cục đó. Không có gì về cách bạn gọi các thay đổi mô hình của mình. Để tham khảo API, bảng cấu hình đầy đủ cho từng dòng phiên bản và hướng dẫn từng bước, hãy xem phân vùng GPU trong Hướng dẫn dành cho nhà phát triển AI của Amazon SageMaker. Để tự mình thử, hãy chạy sổ ghi chép mẫu phân vùng GPU, sổ ghi chép này triển khai một số mô hình trên các phân vùng của một điểm cuối GPU duy nhất. Sự thay đổi lớn hơn cần được ghi nhớ khi bạn lập kế hoạch về năng lực. Mỗi bộ tăng tốc được hỗ trợ giờ đây có nhiều kích cỡ thay vì một. Liệu một phân vùng của GPU mới hơn hay toàn bộ bộ tăng tốc của GPU cũ hơn có phải là đơn vị phù hợp cho một kiểu máy nhất định không còn là câu hỏi bạn cần trả lời bằng cách làm tròn số. Đó là thứ bạn có thể đo lường được.
Về các tác giả
Bản quyền & Xuất xứ thông tin
Bài viết này được tổng hợp và phân tích AI từ ấn phẩm AWS Machine Learning Blog. Mọi bản quyền nội dung thuộc về tác giả và toà soạn gốc.