Xây dựng ứng dụng AI giọng nói có độ trễ cực thấp trên AWS
Tóm lược nhanh
Tổng hợp và đối chiếu bởi gemini-2.0-flash-thinking-exp
“AI đàm thoại đang thay đổi cách con người tương tác với công nghệ.”
Các điểm cốt lõi
- 1.AI đàm thoại đang thay đổi cách con người tương tác với công nghệ.
- 2.Từ trợ lý ảo và trung tâm liên hệ được hỗ trợ bởi AI cho đến các công cụ trợ năng và dịch thuật theo thời gian thực, giao diện ưu tiên bằng giọng nói đang nhanh chóng trở thành chế độ tương tác mặc định cho hàng triệu người dùng trên toàn thế giới.
- 3.Tuy nhiên, việc mang lại trải nghiệm giọng nói thực sự tự nhiên vẫn là một trong những thách thức khó khăn nhất trong cơ sở hạ tầng AI.
AI đàm thoại đang thay đổi cách con người tương tác với công nghệ. Từ trợ lý ảo và trung tâm liên hệ được hỗ trợ bởi AI cho đến các công cụ trợ năng và dịch thuật theo thời gian thực, giao diện ưu tiên bằng giọng nói đang nhanh chóng trở thành chế độ tương tác mặc định cho hàng triệu người dùng trên toàn thế giới. Tuy nhiên, việc mang lại trải nghiệm giọng nói thực sự tự nhiên vẫn là một trong những thách thức khó khăn nhất trong cơ sở hạ tầng AI. Người dùng mong đợi khả năng phản hồi giống như con người. Độ trễ quá mức có thể phá vỡ luồng trò chuyện và làm xói mòn lòng tin. Để cảm thấy tự nhiên, lời nói do AI tạo ra phải đến trong cùng khoảng thời gian với thời gian thay phiên nhau của con người. Bài đăng này giới thiệu cách Cartesia, Đối tác AWS chuyên về AI giọng nói theo thời gian thực, sử dụng Mô hình không gian trạng thái (SSM) được xây dựng có mục đích và cơ sở hạ tầng AWS để cung cấp chuyển văn bản thành giọng nói và giọng nói thành văn bản dưới 100 mili giây ở quy mô toàn cầu. Các nhà phát triển có thể xây dựng trải nghiệm giọng nói không thể phân biệt được với cuộc trò chuyện giữa con người với nhau. Sự gia tăng của AI đàm thoại và kỳ vọng về độ trễ Nhu cầu về AI giọng nói thời gian thực đang tăng nhanh trong các ngành:
Trung tâm liên lạc: Các nhân viên AI xử lý hàng triệu tương tác của khách hàng yêu cầu tạo ra giọng nói tức thời để duy trì cuộc đối thoại tự nhiên. Telehealth: Tư vấn bệnh nhân từ xa yêu cầu giọng nói có độ trễ thấp để giao tiếp chính xác và đồng cảm. Thế giới trò chơi và ảo: Trải nghiệm nhập vai yêu cầu tổng hợp giọng nói theo thời gian thực cho các nhân vật không phải người chơi (NPC) và tương tác của người chơi. Khả năng truy cập: Trình đọc màn hình và giao diện giọng nói phải phản hồi ngay lập tức để phục vụ người dùng khiếm thị. Bán hàng trong và ngoài nước: Các đại lý bán hàng AI phải phản hồi mà không có những khoảng dừng khó xử để xác định khách hàng tiềm năng, xử lý các phản đối và giữ chân khách hàng tiềm năng.
Các mô hình chuyển văn bản thành giọng nói (TTS) dựa trên máy biến áp truyền thống gặp khó khăn với độ trễ truyền phát vì chúng xử lý toàn bộ chuỗi trước khi tạo đầu ra. Hạn chế về kiến trúc này tạo ra một áp lực cơ bản: chất lượng cao hơn thường có nghĩa là độ trễ cao hơn. Một loại mô hình mới, Mô hình Không gian Trạng thái, giải quyết sự cân bằng này. AI cho giọng nói: Mô hình không gian trạng thái (SSM) Mô hình không gian trạng thái (SSM) có cách tiếp cận xử lý trình tự khác về cơ bản so với máy biến áp, kiến trúc đằng sau hầu hết AI ngày nay. Máy biến áp sử dụng một cơ chế gọi là sự chú ý, so sánh mọi phần tử trong chuỗi với mọi phần tử khác. Kết quả là số lượng tính toán tăng theo phương trình bậc hai khi chuỗi dài hơn. Thay vào đó, SSM coi chuỗi là một hệ thống phát triển liên tục theo thời gian, xử lý chuỗi theo từng bước và chuyển tiếp trạng thái nội bộ nhỏ gọn về phía trước. Điều này có thể được chuyển đổi thành dạng máy tính xử lý hiệu quả, giữ chi phí thấp cho các chuỗi dài nhất định. Hiệu quả này làm cho SSM rất phù hợp với dữ liệu truyền phát theo thời gian thực như lời nói trực tiếp. Ưu điểm chính của SSM để xử lý âm thanh bao gồm:
Các phần phụ thuộc tầm xa chất lượng cao: SSM có cấu trúc là một dạng lặp lại tuyến tính, nhưng tham số hóa trạng thái của chúng bảo toàn thông tin trên các chuỗi âm thanh dài, tránh hiện tượng suy giảm tín hiệu tầm xa vốn hạn chế các mạng thần kinh tái phát cổ điển (RNN), chẳng hạn như mạng bộ nhớ ngắn hạn (LSTM). Dấu chân bộ nhớ không đổi: Không giống như các máy biến áp lưu trữ tất cả các mã thông báo trước đó, SSM duy trì trạng thái ẩn có kích thước cố định. Hỗ trợ phát trực tuyến gốc: Cấu trúc lặp lại xử lý từng mã thông báo đầu vào, do đó, nó hỗ trợ phát trực tuyến thực sự mà không cần sửa đổi kiến trúc.
Những đặc tính này làm cho SSM trở nên phù hợp nhất cho các ứng dụng thoại thời gian thực, nơi cả chất lượng và độ trễ đều không thể thương lượng được. Cách thức hoạt động: SSM cho giọng nói thời gian thực Cartesia áp dụng những lợi thế SSM này để hoạt động trong hai mẫu giọng nói sản xuất: Sonic để tạo giọng nói và Ink để phiên âm. Giới thiệu Cartesia Cartesia là một công ty tình báo đa phương thức thời gian thực đã xây dựng một ứng dụng AI bằng giọng nói, được xây dựng có mục đích dựa trên kiến trúc Mô hình Không gian Trạng thái. Được thành lập bởi các nhà nghiên cứu tiên phong trong những tiến bộ của SSM, ứng dụng của Cartesia được thiết kế để truyền trực tuyến suy luận ở rìa nhận thức của con người. Ứng dụng này có hai mô hình cốt lõi, Sonic cho chuyển văn bản thành giọng nói và Ink cho chuyển giọng nói thành văn bản, cả hai đều được tối ưu hóa cho độ trễ byte đầu tiên dưới 100 mili giây trong khi vẫn duy trì đầu ra chất lượng phòng thu. Sonic (chuyển văn bản thành giọng nói) Sonic là mô hình truyền trực tuyến văn bản thành giọng nói hàng đầu của Cartesia, cung cấp khả năng tổng hợp giọng nói cực kỳ thực tế với độ trễ dưới 100 mili giây:
Byte âm thanh đầu tiên trong khoảng 90 mili giây: Người dùng nghe thấy giọng nói phản hồi gần như ngay lập tức. Chất lượng giọng nói siêu thực: Ngữ điệu tự nhiên, cảm xúc và tính biểu cảm trên hơn 44 ngôn ngữ. Nhân bản giọng nói với dữ liệu tối thiểu: Tạo giọng nói tùy chỉnh có âm thanh tự nhiên từ các mẫu âm thanh 10 giây. Kiến trúc truyền phát gốc: Âm thanh bắt đầu tạo trước khi nhận được văn bản đầu vào đầy đủ. Tổng hợp theo ngữ cảnh: Duy trì giọng điệu và phong cách nhất quán trong các đoạn văn dài.
Sonic được khuyên dùng cho những nhóm muốn có thời gian sản xuất nhanh nhất với chi phí vận hành tối thiểu. Gọi API và nhận âm thanh phát trực tuyến trong thời gian thực. Viết tay (chuyển giọng nói thành văn bản) Ink là mô hình chuyển giọng nói thành văn bản trực tuyến của Cartesia, được xây dựng có mục đích cho các ứng dụng AI đàm thoại:
Phát hiện lần lượt tự nhiên: Tự động xác định khi người nói đã kết thúc lượt của mình, giảm bớt những khoảng dừng khó xử mà không có mô hình phát hiện hoạt động giọng nói (VAD) hoặc điểm kết thúc riêng biệt. Chỉ điểm kết thúc nhận biết ngữ cảnh: Sử dụng sự hiểu biết về ngữ nghĩa để phân biệt giữa các khoảng dừng giữa câu và ranh giới cuộc trò chuyện thực sự. Truyền trực tuyến bản ghi: Phát ra một phần bản ghi trong thời gian thực khi người dùng nói, do đó, mô hình ngôn ngữ lớn xuôi dòng (LLM) có thể bắt đầu hình thành phản hồi trước khi lượt kết thúc. Độ bền chống ồn: Duy trì độ chính xác trong môi trường ồn ào thường gặp khi triển khai trong thế giới thực. Hỗ trợ nhiều loa: Xử lý các chuyển tiếp giọng nói và loa chồng chéo một cách duyên dáng.
Cùng với nhau, Sonic và Ink cung cấp kho AI giọng nói hoàn chỉnh cần thiết để xây dựng các tác nhân đàm thoại giống con người. Triển khai Cartesia trên AWS Nếu cần chủ quyền dữ liệu, kiểm soát độ trễ hoặc tuân thủ, bạn có thể triển khai mô hình Cartesia trực tiếp vào tài khoản AWS của riêng mình. Sonic được phân phối dưới dạng gói mô hình AI SageMaker của Amazon thông qua AWS Marketplace mà bạn triển khai tới điểm cuối SageMaker AI chạy hoàn toàn trong đám mây riêng ảo (VPC) của mình. Dữ liệu suy luận không rời khỏi tài khoản của bạn. Các mẫu triển khai trong phần này bao gồm Sonic. Ink hiện có sẵn thông qua API Cartesia mà bạn có thể mua thông qua danh sách Nền tảng AI của Cartesia Voice trong AWS Marketplace. Hai mẫu chính có sẵn cho Sonic. Tùy chọn 1: Amazon SageMaker AI (gói mô hình AWS Marketplace) Triển khai trên Amazon SageMaker AI là con đường nhanh nhất đến điểm cuối Sonic trong VPC được quản lý. Sonic được cung cấp dưới dạng gói mô hình AWS Marketplace, do đó, chỉ cần thực hiện bước đăng ký một lần để cấp cho tài khoản của bạn ARN gói mô hình dành riêng cho Khu vực AWS. Sau đó, bạn tạo điểm cuối SageMaker AI từ ARN đó, từ bảng điều khiển hoặc bằng SageMaker hoặc Boto3 SDK. Các bước sau đây tuân theo sổ ghi chép triển khai chính thức của Cartesia. Điều kiện tiên quyết Chạy từ Phiên bản sổ ghi chép Amazon SageMaker hoặc SageMaker Studio. Vai trò thực thi AWS Identity and Access Management (IAM) cần có AmazonSageMakerFullAccess. Để đăng ký, vai trò của bạn (và bạn) cần aws-marketplace:Subscribe, aws-marketplace:Hủy đăng ký và aws-marketplace:ViewSubscriptions. Nếu không, tài khoản phải đã được đăng ký vào danh sách. Trước khi triển khai, hãy chọn loại phiên bản được hỗ trợ từ trường SupportedRealtimeInferenceInstanceTypes của gói mô hình:
ml.g6e.xlarge hoặc lớn hơn ml.g7e.2xlarge hoặc lớn hơn ml.g7.2xlarge hoặc lớn hơn ml.p5.48xlarge ml.p5en.48xlarge
Nếu giá trị áp dụng của loại phiên bản bạn đã chọn thấp hơn mức sử dụng hiện tại cộng với số lượng phiên bản điểm cuối theo kế hoạch của bạn, thì bạn có thể cần phải yêu cầu tăng hạn mức dịch vụ. Xem hạn ngạch AI của SageMaker để biết chi tiết. Triển khai Sonic 3.6 tới điểm cuối SageMaker Trong Amazon SageMaker JumpStart, bạn có thể đăng ký gói mô hình AWS Marketplace, tạo mô hình SageMaker và lưu trữ mô hình đó trên điểm cuối thời gian thực. Bốn bước sau đây hiển thị đường dẫn triển khai.
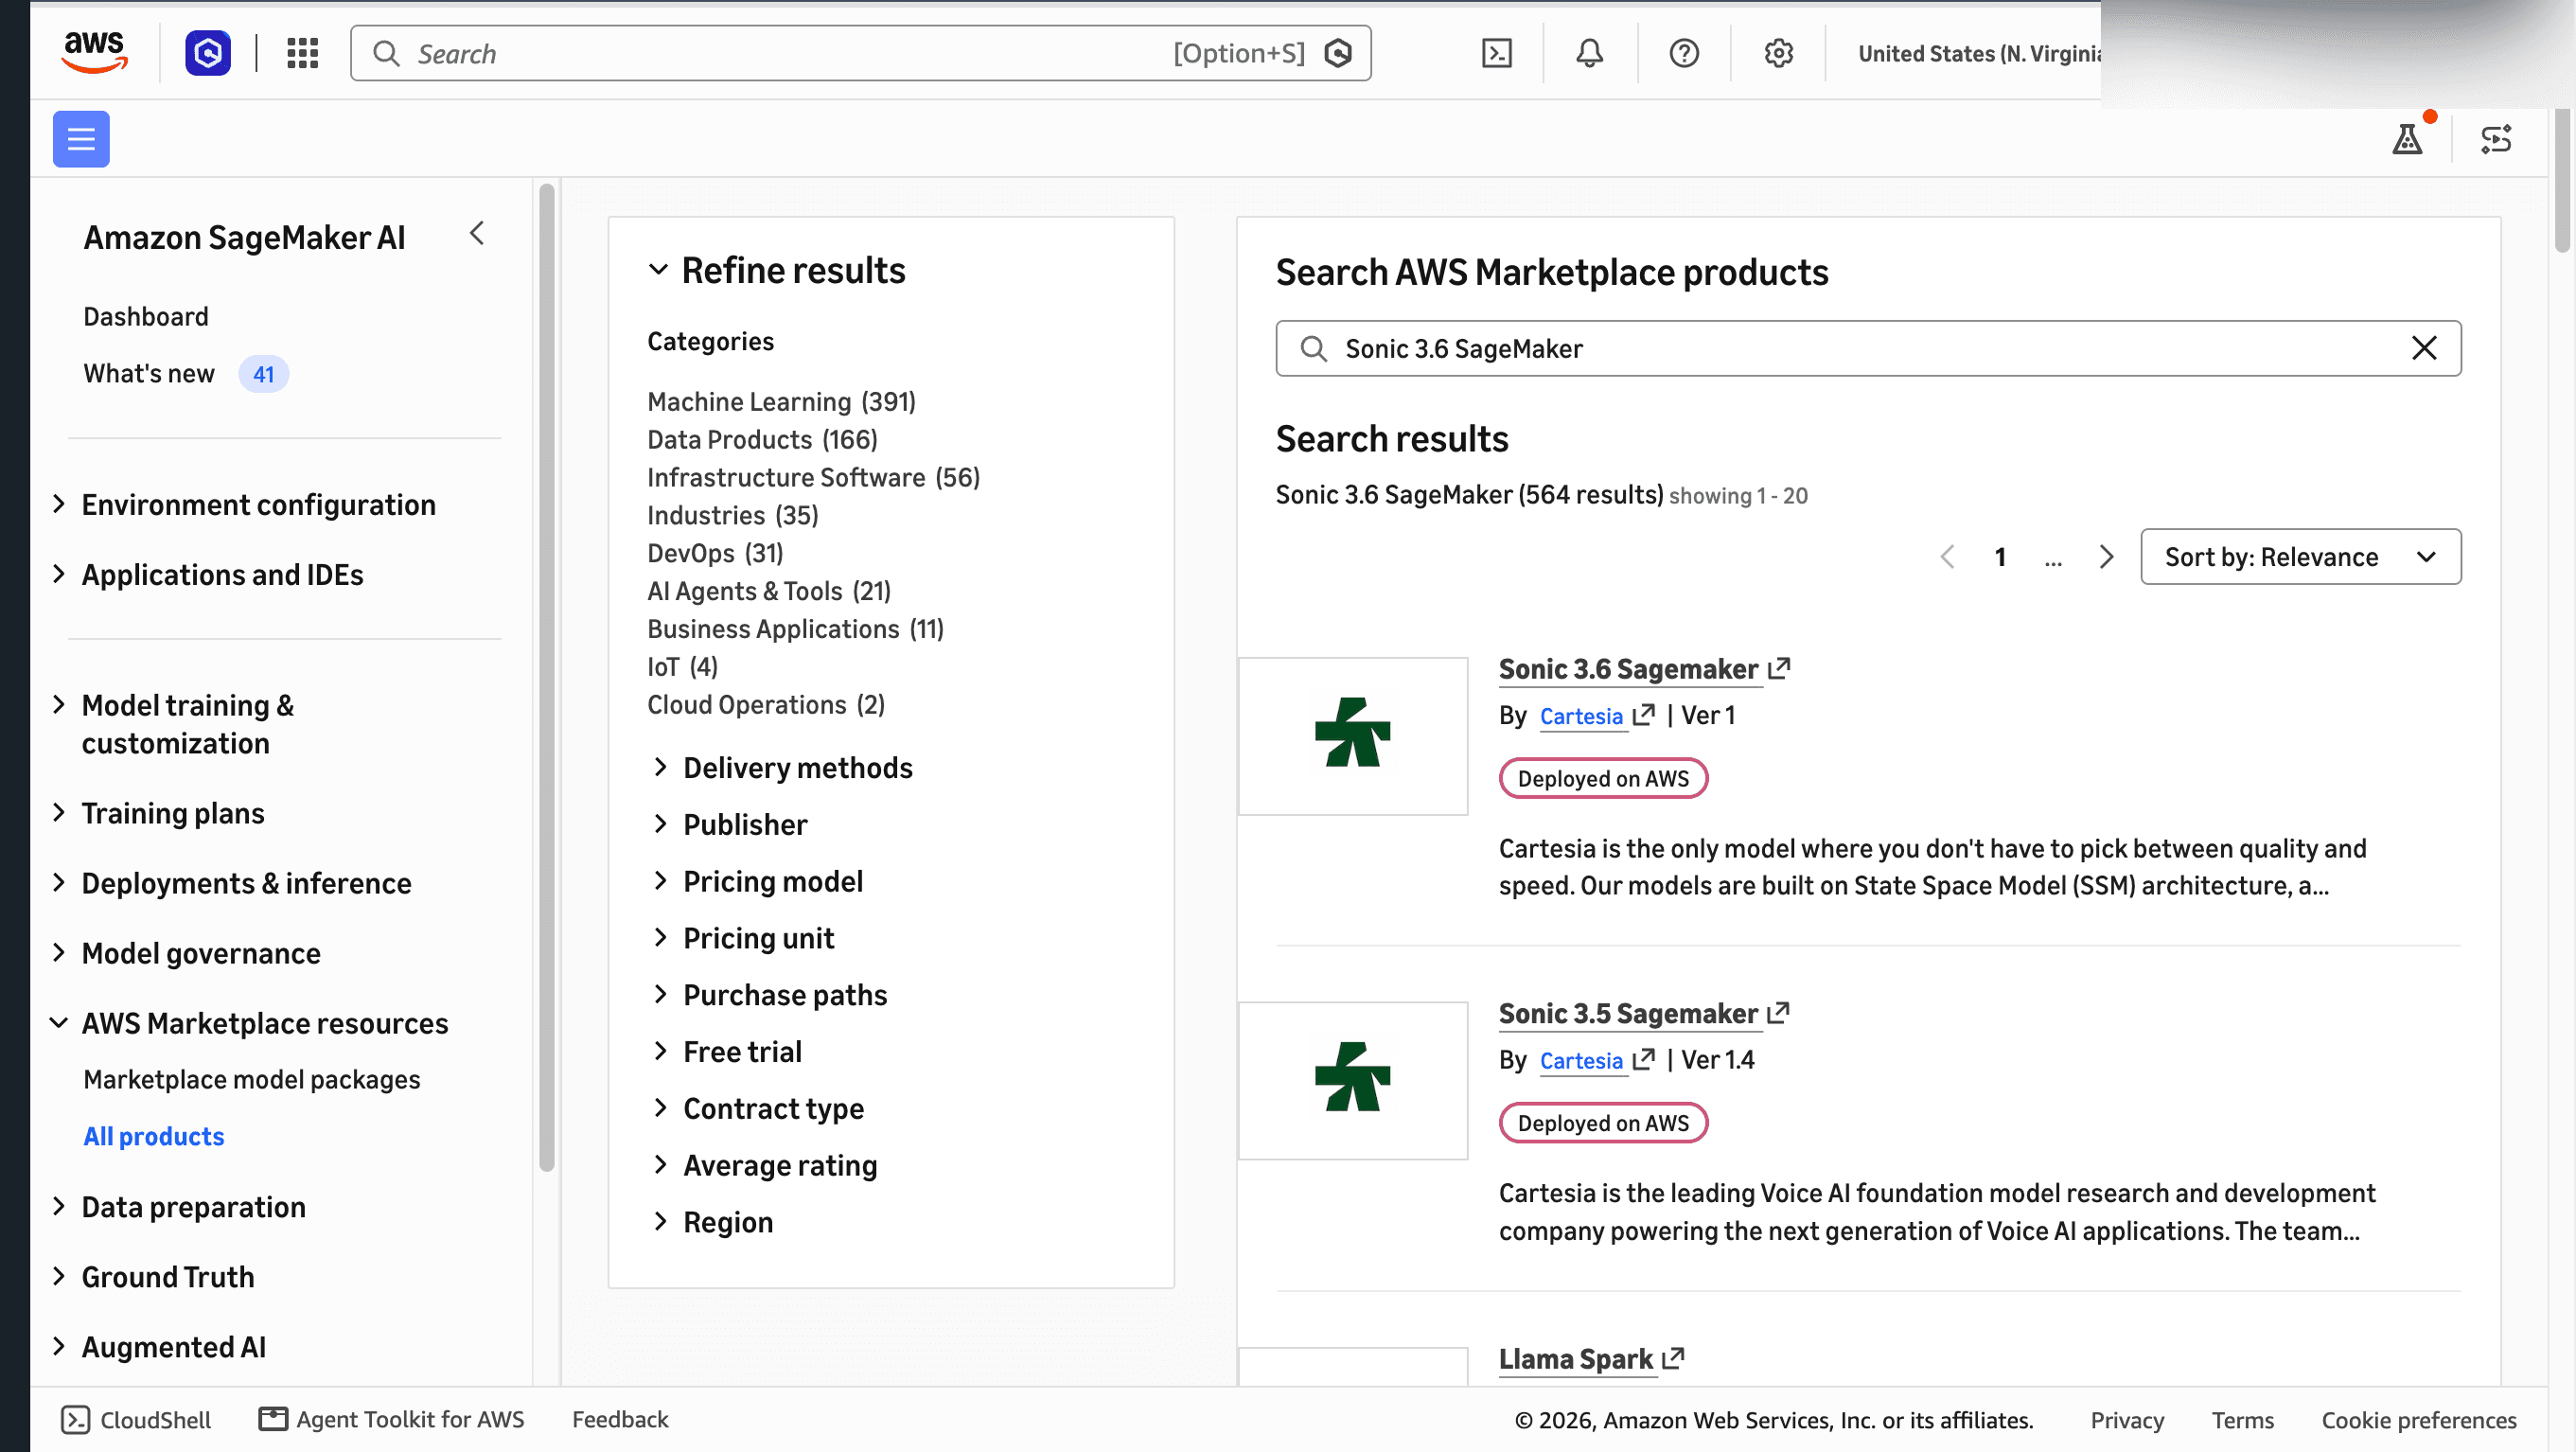
Trong SageMaker AI, hãy mở tài nguyên AWS Marketplace, sau đó là Tất cả sản phẩm. Tìm kiếm Sonic 3.6 SageMaker và chọn danh sách Cartesia.
Hình 1: Tìm kiếm AWS Marketplace cho gói mô hình Cartesia Sonic 3.6 SageMaker
Chọn Xem các tùy chọn mua hàng, xem lại giá cả và các điều khoản rồi đăng ký. Đăng ký cấp cho tài khoản AWS của bạn quyền truy cập vào gói mô hình. Nó không triển khai tài nguyên.
Hình 2: Danh sách Cartesia Sonic 3.6 trên AWS Marketplace
Mở Triển khai & suy luận > Mô hình có thể triển khai, chọn Tạo mô hình, chọn Sử dụng đăng ký gói mô hình từ AWS Marketplace và chọn Sonic 3.6 SageMaker. Chọn vai trò thực thi, sau đó tạo mô hình.
Hình 3: Tạo mô hình SageMaker từ gói đăng ký Sonic 3.6
Tạo điểm cuối thời gian thực từ mô hình có phiên bản GPU được hỗ trợ, chẳng hạn như ml.g6e.2xlarge. Điểm cuối xuất hiện đầu tiên với trạng thái Đang tạo. Đợi InService trước khi gọi nó.
Hình 4: Điểm cuối SageMaker cho Sonic 3.6
ARN của gói mô hình dành riêng cho từng khu vực. Để xác minh gói Sonic 3.6 ở Miền Đông Hoa Kỳ (Bắc Virginia) bằng API SageMaker, hãy chạy:
xuất MODEL_PACKAGE_ARN="arn:aws:sagemaker:us-east-1:865070037744:model-package/sonic36-sagemaker-v0-c6e9cacffcdf31178d1bd7c98c587480"
aws sagemaker mô tả-model-gói
--model-package-name "$MODEL_PACKAGE_ARN"
--khu vực chúng tôi-đông-1
--query '{Status:ModelPackageStatus,ProductId:InferenceSpecification.Containers[0].ProductId,InstanceTypes:InferenceSpecification.SupportedRealtimeInferenceInstanceTypes}'
Sau khi điểm cuối đến InService, hãy gọi nó bằng API SageMaker Runtime InvokeEndpointWithResponseStream và xử lý luồng âm thanh được trả về trong ứng dụng của bạn. Tùy chọn 2: Tự quản lý trên phiên bản GPU EC2 Một số nhóm có cơ sở hạ tầng GPU hiện có, yêu cầu kết nối mạng nghiêm ngặt hoặc nhu cầu định vị Cartesia với các dịch vụ khác. Đối với những trường hợp này, bạn có thể tự chạy vùng chứa mô hình trên các phiên bản GPU Amazon Elastic Computing Cloud (Amazon EC2). Điều này cung cấp cho bạn toàn quyền kiểm soát thời gian chạy, mở rộng quy mô và đường dẫn mạng. Nó sử dụng hình ảnh vùng chứa của Cartesia, lấy từ Cartesia, thay vì gói mô hình AWS Marketplace.
Hình 5: Luồng triển khai tự quản lý cho Cartesia Sonic trên phiên bản GPU Amazon EC2
Lấy hình ảnh container. Yêu cầu hình ảnh vùng chứa Sonic và các điều khoản cấp phép từ Cartesia. Sao chép nó vào kho lưu trữ Amazon Elastic Container Regist (Amazon ECR) riêng của bạn để mặt phẳng điện toán của bạn có thể lấy nó bằng thông tin xác thực trong phạm vi IAM thay vì liên hệ với một cơ quan đăng ký bên ngoài trên quy mô lớn. Chọn dòng phiên bản GPU của bạn. Sonic chạy trên các phiên bản GPU NVIDIA. Dòng G6 (L4) và G6e (L40S) là sự cân bằng tối ưu cho TTS thời gian thực. G5 (A10G) trước đó cũng hoạt động. So khớp bộ nhớ GPU và vCPU với đồng thời mục tiêu của bạn và ưu tiên một phiên bản GPU đơn cho mỗi bản sao mô hình để có khả năng mở rộng quy mô đơn giản nhất. Cung cấp mặt phẳng điện toán (Amazon Elastic Container Service (Amazon ECS) hoặc Amazon Elastic Kubernetes Service (Amazon EKS)). Đối với ECS: đăng ký định nghĩa tác vụ GPU (đặt yêu cầu tài nguyên GPU của bộ chứa, ví dụ: Yêu cầu tài nguyên với loại GPU) và chạy nó dưới dạng dịch vụ đằng sau Cân bằng tải ứng dụng. Đối với EKS: tạo nhóm nút GPU (hoặc nhà cung cấp Karpenter) bằng cách sử dụng AMI được tối ưu hóa cho GPU của EKS, cài đặt plugin thiết bị NVIDIA và triển khai vùng chứa dưới dạng Triển khai do Dịch vụ/Ingress đứng đầu. Cấu hình mạng cho độ trễ thấp. Đặt các nút suy luận trong một nhóm vị trí cụm để giảm thiểu độ trễ giữa các nút, giữ các bản sao trong một Vùng sẵn sàng duy nhất cho đường dẫn chặt chẽ nhất và sử dụng điểm cuối VPC cho các lần kéo ECR/S3. Đối với người gọi kết hợp hoặc tại chỗ, hãy chấm dứt lưu lượng truy cập qua AWS Direct Connect hoặc Network Load Balancer riêng để tránh các bước nhảy vọt qua Internet công cộng. Tải trọng lượng mô hình một cách hiệu quả. Lưu trữ trọng số mô hình trên một ổ đĩa dùng chung, có độ trễ thấp (Amazon Elastic File System (Amazon EFS) hoặc Amazon FSx for Lustre) được gắn trên các bản sao để các nhóm/tác vụ mới bắt đầu mà không cần tải xuống lại mỗi cấu phần phần mềm nhiều GB. Làm ấm mô hình khi khởi động vùng chứa và thực hiện kiểm tra tình trạng để bộ cân bằng tải chỉ định tuyến đến các bản sao sẵn sàng. Điều chỉnh theo đợt và đồng thời. Đặt kích thước lô tối đa và giới hạn luồng đồng thời của vùng chứa để phù hợp với hồ sơ lưu lượng truy cập của bạn . Kích thước lô cao hơn giúp cải thiện mức sử dụng GPU nhưng tăng thêm độ trễ byte đầu tiên, vì vậy hãy điều chỉnh theo mục tiêu dưới 100 mili giây của bạn. Điểm chuẩn các luồng trên mỗi GPU để tìm dung lượng bản sao mà bạn sẽ mở rộng quy mô. Triển khai quy mô tự động tùy chỉnh. Chia tỷ lệ dựa trên tín hiệu phản ánh tải thực, số lượng luồng âm thanh đang hoạt động hoặc mức sử dụng GPU, thay vì CPU. Trên Amazon ECS, hãy sử dụng AWS Application Auto Scaling với chỉ số Amazon CloudWatch tùy chỉnh. Trên Amazon EKS, sử dụng HPA/KEDA được điều khiển bởi GPU hoặc số liệu đếm luồng, với Karpenter (hoặc Cluster Autoscaler) sẽ thêm các nút GPU khi các bản sao phát triển. Thêm khả năng quan sát và khả năng phục hồi. Phát ra độ trễ (thời gian tính đến byte đầu tiên), số lượng luồng và số liệu GPU tới CloudWatch. Chạy ít nhất hai bản sao trên các nút để sẵn sàng. Đặt các chính sách cập nhật luân phiên hoặc rút cạn để quá trình triển khai không làm mất luồng âm thanh trong quá trình triển khai. Phương pháp này được khuyến nghị khi tích hợp Cartesia vào hệ thống máy học (ML) hiện có, đáp ứng các yêu cầu về kết nối hoặc tuân thủ không có sẵn thông qua các dịch vụ được quản lý hoặc tối ưu hóa chi phí với dung lượng GPU Dự trữ hoặc Spot. Sự đánh đổi là bạn sở hữu việc cung cấp, mở rộng quy mô, vá lỗi và giám sát mà SageMaker sẽ xử lý cho bạn. Tìm hiểu thêm: Xem định nghĩa tác vụ của Amazon ECS cho khối lượng công việc GPU, quản lý thiết bị GPU NVIDIA trên Amazon EKS và bắt đầu với các phiên bản EC2 được GPU tăng tốc. Chọn mô hình triển khai phù hợp AWS cung cấp hai cách để chạy Sonic, mỗi cách phù hợp với điểm xuất phát khác nhau. Đường dẫn được quản lý, sử dụng gói mô hình Amazon SageMaker AI từ AWS Marketplace, là đường dẫn mặc định cho hầu hết các nhóm: bạn đăng ký, triển khai tới điểm cuối trong VPC trong vài phút và để SageMaker xử lý việc mở rộng quy mô và vận hành. Đường dẫn tự quản lý, tự chạy vùng chứa mô hình trên các phiên bản GPU EC2, được thiết kế cho các nhóm có những hạn chế cụ thể: cơ sở hạ tầng GPU hiện có, yêu cầu kết nối mạng nghiêm ngặt hoặc nhu cầu định vị Cartesia cùng với các dịch vụ khác. Đối với các nhóm này, toàn quyền kiểm soát thời gian chạy, mở rộng quy mô và mạng Đường dẫn ork quan trọng hơn thời gian triển khai. Bảng sau đây tóm tắt cách so sánh cả hai.
Tiêu chí SageMaker (Thị trường) GPU EC2 (Tự quản lý)
Thời gian triển khai Phút sau khi đăng ký Giờ đến ngày
Tính toán Điểm cuối thời gian thực. Xem SupportedRealtimeInferenceInstanceTypes để biết các phiên bản được hỗ trợ. Phiên bản GPU EC2
Kiểm soát hoạt động Được quản lý bởi AWS Kiểm soát hoàn toàn
Chia tỷ lệ SageMaker tự động chia tỷ lệ Chính sách chia tỷ lệ tùy chỉnh
Mô hình chi phí Phí phần mềm + mỗi giờ phiên bản + cơ sở hạ tầng EC2 (Dự trữ/Tiết kiệm giao ngay)
Mạng Điểm cuối trong VPC (cách ly mạng) Nhóm vị trí, Kết nối trực tiếp
Tốt nhất cho Nhanh chóng, được quản lý, trong VPC Tùy chỉnh hồng ngoại, kiểm soát tối đa
Ngoài việc triển khai Cartesia trong tài khoản của riêng bạn, những mô hình này đã được chứng minh trong quá trình sản xuất bên trong các dịch vụ của Amazon và rất ít môi trường đòi hỏi giọng nói theo thời gian thực hơn là một trung tâm liên lạc trực tiếp. Amazon Connect chính xác là nền tảng chứng minh điều đó. Đang sản xuất: Amazon Connect Phần này trình bày cách các mẫu giọng nói của Cartesia hoạt động bên trong Amazon Connect ở quy mô sản xuất. Amazon Connect là gì? Amazon Connect là dịch vụ trung tâm liên lạc dựa trên đám mây mà các doanh nghiệp sử dụng để thiết lập và chạy các hoạt động hỗ trợ khách hàng nhằm xử lý các cuộc gọi thoại, trò chuyện và nhắn tin đến và đi. Với mức giá thanh toán theo mức sử dụng và khả năng tích hợp sâu với các dịch vụ AWS, Amazon Connect hỗ trợ hàng triệu tương tác của khách hàng hàng ngày trong các ngành từ dịch vụ tài chính đến chăm sóc sức khỏe. Cách Cartesia hỗ trợ trải nghiệm Amazon Connect Các mô hình AI giọng nói của Cartesia tích hợp nguyên bản với Amazon Connect để mang lại trải nghiệm trung tâm liên lạc thế hệ tiếp theo:
Phản hồi tức thì: Giảm bớt những khoảng dừng không tự nhiên làm xói mòn niềm tin của khách hàng đối với các tương tác do AI cung cấp. Phiên âm theo thời gian thực: Ink cung cấp phiên âm trực tiếp với tính năng phát hiện lần lượt thông minh dành cho quy trình làm việc do tổng đài viên hỗ trợ. Hỗ trợ đa ngôn ngữ: Phục vụ khách hàng bằng hơn 44 ngôn ngữ với chất lượng giọng nói ổn định và nhịp điệu tự nhiên. Cơ sở hạ tầng có thể mở rộng: Xử lý lưu lượng truy cập tăng đột biến trong giờ cao điểm mà không làm giảm chất lượng âm thanh hoặc độ trễ.
Bằng cách kết hợp khả năng điều phối đa kênh của Amazon Connect với AI giọng nói theo thời gian thực của Cartesia, bạn có thể tự động hóa các tương tác phức tạp của khách hàng trong khi vẫn duy trì trải nghiệm tự nhiên, phản hồi nhanh nhằm tạo dựng niềm tin và lòng trung thành. Bắt đầu Bạn đã sẵn sàng xây dựng các ứng dụng AI giọng nói có độ trễ cực thấp chưa? Dưới đây là các bước tiếp theo:
Triển khai Sonic thông qua SageMaker JumpStart: Tìm kiếm “Cartesia” trong trung tâm mô hình SageMaker JumpStart và triển khai điểm cuối thời gian thực trong vài phút. Hãy thử API Cartesia: Bắt đầu với hướng dẫn bắt đầu Cartesia. Không cần thiết lập cơ sở hạ tầng. Khám phá kiến trúc tham khảo: Truy cập kho lưu trữ Cartesia GitHub để xem sổ ghi chép mẫu, mẫu triển khai và ví dụ tích hợp. Liên hệ với nhóm: Liên hệ với Cartesia trên AWS Marketplace.
Về các tác giả
Bản quyền & Xuất xứ thông tin
Bài viết này được tổng hợp và phân tích AI từ ấn phẩm AWS Machine Learning Blog. Mọi bản quyền nội dung thuộc về tác giả và toà soạn gốc.


