NVIDIA công bố kết quả huấn luyện của Vera Rubin, điểm số tác vụ AI còn chờ xác minh
Tóm lược nhanh
“NVIDIA công bố kết quả thử nghiệm đầu tiên của nền tảng Vera Rubin trên MLPerf Training và...”
Các điểm cốt lõi
- 1.Theo NVIDIA, nền tảng của hãng là hệ thống duy nhất có kết quả ở mọi bài thử MLPerf Training v6.1 trong đợt này. Các bài thử bao gồm mô hình ngôn ngữ lớn, tạo ảnh, hệ thống gợi ý và huấn luyện bổ sung bằng học tăng cường.
- 2.Trong kết quả đầu tiên, NVIDIA cho biết Vera Rubin NVL72 đạt hiệu năng trên mỗi GPU cao hơn tối đa hai lần so với hệ thống GB300 NVL72 đã được tối ưu hóa.
- 3.NVIDIA báo cáo rằng trên bài thử DeepSeek-V3, khi tăng số GPU Vera Rubin NVL72 từ 256 lên 1.024, thời gian huấn luyện giảm từ 16 phút xuống khoảng bốn phút, với hiệu suất mở rộng khoảng 97%.
- 4.Với bài thử tác vụ AI dùng mô hình Kimi K3, NVIDIA báo cáo Vera Rubin NVL72 đạt thông lượng trên mỗi watt cao hơn hơn 10 lần GB300 NVL72 khi so sánh tại mức tương tác tối thiểu chung là 50 token mỗi giây cho mỗi người dùng. Kết quả Vera Rubin mới ở dạng tạm thời, chưa được MLCommons xác minh và có thể thay đổi sau bình duyệt.
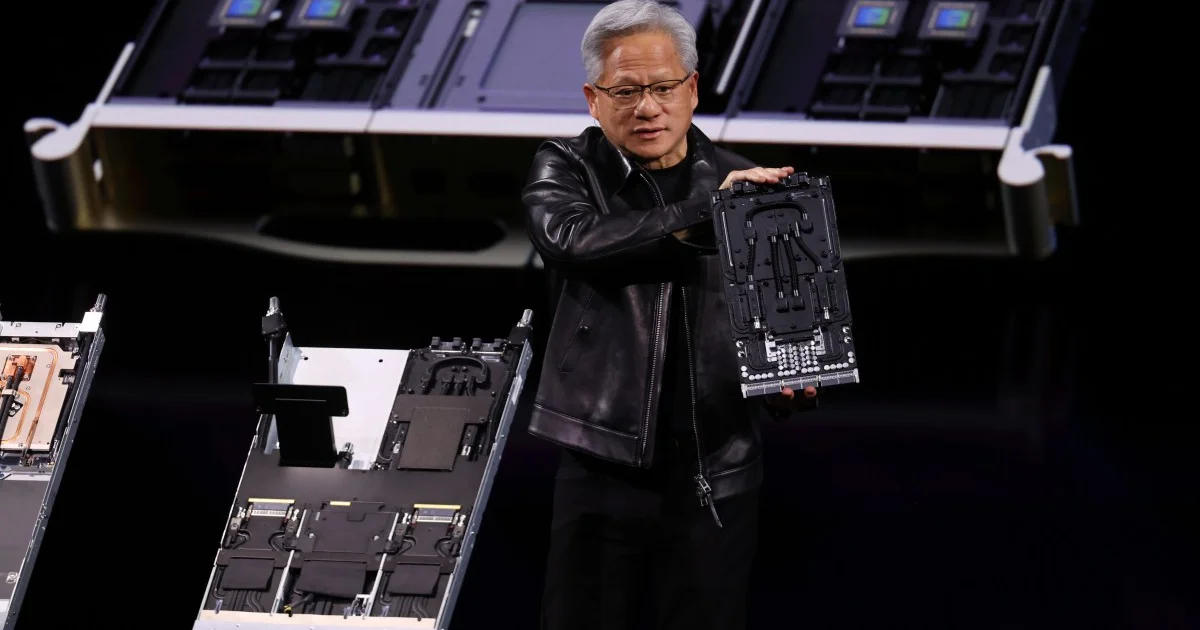
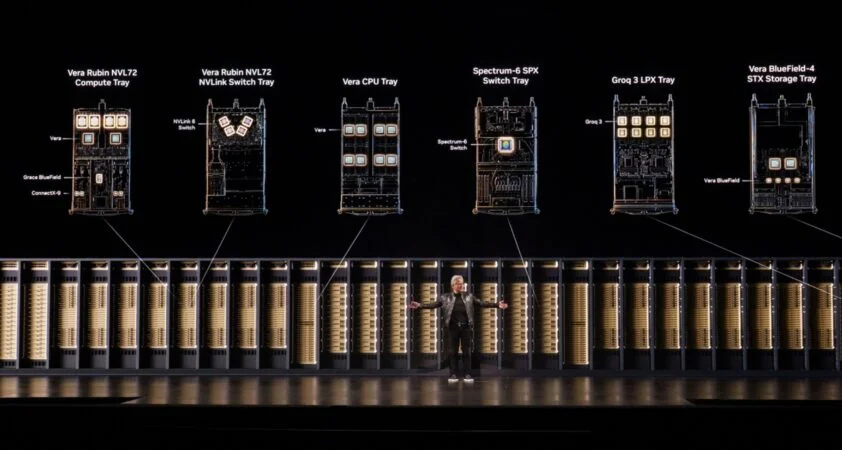
NVIDIA công bố kết quả thử nghiệm đầu tiên của nền tảng Vera Rubin trên MLPerf Training và MLPerf Endpoints. Hãng báo cáo mức tăng hiệu năng huấn luyện so với hệ thống GB300, nhưng kết quả về hiệu suất điện năng khi chạy tác vụ AI vẫn đang chờ MLCommons xác minh.
Bối cảnh và chi tiết công nghệ
Theo NVIDIA, nền tảng của hãng là hệ thống duy nhất có kết quả ở mọi bài thử MLPerf Training v6.1 trong đợt này. Các bài thử bao gồm mô hình ngôn ngữ lớn, tạo ảnh, hệ thống gợi ý và huấn luyện bổ sung bằng học tăng cường.
Trong kết quả đầu tiên, NVIDIA cho biết Vera Rubin NVL72 đạt hiệu năng trên mỗi GPU cao hơn tối đa hai lần so với hệ thống GB300 NVL72 đã được tối ưu hóa.
NVIDIA báo cáo rằng trên bài thử DeepSeek-V3, khi tăng số GPU Vera Rubin NVL72 từ 256 lên 1.024, thời gian huấn luyện giảm từ 16 phút xuống khoảng bốn phút, với hiệu suất mở rộng khoảng 97%.
Với bài thử tác vụ AI dùng mô hình Kimi K3, NVIDIA báo cáo Vera Rubin NVL72 đạt thông lượng trên mỗi watt cao hơn hơn 10 lần GB300 NVL72 khi so sánh tại mức tương tác tối thiểu chung là 50 token mỗi giây cho mỗi người dùng. Kết quả Vera Rubin mới ở dạng tạm thời, chưa được MLCommons xác minh và có thể thay đổi sau bình duyệt.
Đánh giá tác động và góc nhìn chuyên môn
Mức tăng thông lượng trên mỗi watt ở bài thử Kimi K3 gắn với một ngưỡng tốc độ phản hồi cụ thể. Vì vậy, chưa thể suy ra cùng mức lợi thế cho mọi mô hình hoặc mọi cách triển khai tác vụ AI.
Kết quả mở rộng trên DeepSeek-V3 cho thấy việc tăng số GPU có thể rút ngắn đáng kể thời gian của bài thử này. Nó chưa cho biết chi phí vận hành của một đợt huấn luyện trong thực tế.
Xu hướng tiếp theo và điều cần theo dõi
Kết quả Vera Rubin trên MLPerf Endpoints sẽ thay đổi thế nào sau quá trình xác minh và bình duyệt của MLCommons?
Các kết quả thử nghiệm này sẽ chuyển thành hiệu năng, điện năng tiêu thụ và chi phí ra sao trong hệ thống khách hàng?