Google tinh chỉnh Đám mây dữ liệu tác nhân của mình để hỗ trợ các nhân viên AI tự trị có khả năng mở rộng cao
Tóm lược nhanh
Tổng hợp và đối chiếu bởi gemini-2.0-flash-thinking-exp
“### Google tinh chỉnh Đám mây dữ liệu tác nhân để hỗ trợ các nhân viên AI tự động có khả năng mở rộn”
Các điểm cốt lõi
- 1.### Google tinh chỉnh Đám mây dữ liệu tác nhân để hỗ trợ các nhân viên AI tự động có khả năng mở rộng cao Trí tuệ nhân tạo không còn chỉ là những trợ lý đàm thoại cho mọi người biết phải làm gì.
- 2.Ngày nay, tất cả đều là về tự động hóa công việc và Google Cloud đang đảm bảo rằng nó sẽ đi đầu trong xu hướng đó với nền tảng Agentic Data Cloud được cải tiến, đã nhận được một loạt bản cập nhật mới ngày hôm nay.
- 3.Đám mây dữ liệu Agentic đã được ra mắt vào đầu năm nay tại Google Cloud Next.
Google tinh chỉnh Đám mây dữ liệu tác nhân để hỗ trợ các nhân viên AI tự động có khả năng mở rộng cao
Trí tuệ nhân tạo không còn chỉ là những trợ lý đàm thoại cho mọi người biết phải làm gì. Ngày nay, tất cả đều là về tự động hóa công việc và Google Cloud đang đảm bảo rằng nó sẽ đi đầu trong xu hướng đó với nền tảng Agentic Data Cloud được cải tiến, đã nhận được một loạt bản cập nhật mới ngày hôm nay.
Đám mây dữ liệu Agentic đã được ra mắt vào đầu năm nay tại Google Cloud Next. Nó được coi là “hệ thống hành động” kiến trúc dành cho các tác nhân AI, thay thế các đường dẫn dữ liệu dựa trên tải, chuyển đổi và trích xuất dễ vỡ, hay ETL, cung cấp các ứng dụng phần mềm cũ. Ưu điểm chính của Đám mây dữ liệu tác nhân là nó đáp ứng nhu cầu của khách hàng ở nơi có dữ liệu của họ, do đó, thay vì buộc họ phải nén tất cả thông tin của mình vào một kho dữ liệu tập trung, lớn, nó cho phép các tác nhân AI truy cập vào dữ liệu đó ở bất cứ nơi nào nó tồn tại.
Trong một bài đăng trên blog, Sirish Chandrasekaran, phó chủ tịch quản lý sản phẩm phân tích dữ liệu của Google, đã nêu ra niềm tin của công ty rằng các tác nhân tự trị chứ không phải con người sẽ sớm trở thành người tiêu dùng dữ liệu chính. Do đó, việc xây dựng một cơ sở hạ tầng được xây dựng có mục đích dành riêng cho họ là điều hợp lý, ưu tiên độ trễ thấp, không di chuyển dữ liệu và quản trị tự động. Chandrasekaran cho biết: “Đó là lý do tại sao chúng tôi xây dựng Đám mây dữ liệu tác nhân - một hệ thống hành động được thiết kế để kích hoạt tất cả dữ liệu của bạn bằng cách phá vỡ các khu vườn có tường bao quanh, mang lại độ chính xác và độ tin cậy cao cũng như hoạt động chủ động với chi phí thấp”.
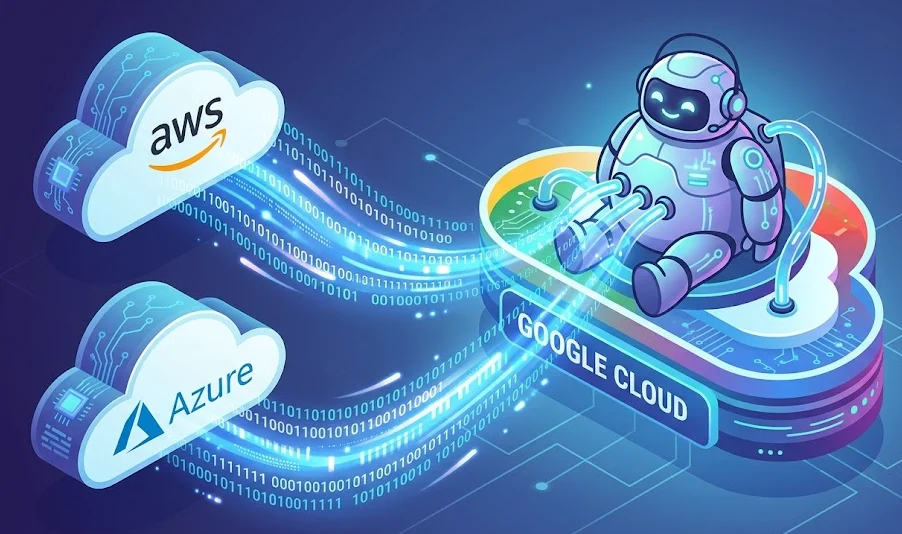
Tính năng mới hàng đầu trong Agentic Data Cloud là Lakehouse không biên giới, một phiên bản đặc biệt của sản phẩm “Lakehouse xuyên biên giới” của Google cũng đã ra mắt tại Cloud Next. Chandrasekaran cho biết Lakehouse không biên giới được xây dựng dựa trên định dạng bảng Apache Iceberg nguồn mở và được thiết kế để loại bỏ xung đột trên nhiều đám mây bằng khả năng lưu vào bộ nhớ đệm mới cho Amazon Web Services và Microsoft Azure. Điều này cho phép các công ty truy vấn dữ liệu từ xa được lưu giữ trong các nền tảng đám mây đó qua liên kết riêng tư an toàn mà không phải trả phí đầu ra.
Chandrasekaran mô tả chi tiết cách thức hoạt động của nó, nói rằng nó tự động lưu trữ các khối dữ liệu được truy xuất trong Google Cloud để tăng tốc các truy vấn tiếp theo. Ngoài ra còn có tính năng tích hợp AlloyDB mới cho phép người dùng truy vấn các bảng Iceberg bên ngoài bằng các truy vấn PostgreSQL tiêu chuẩn mà không cần phải sao chép dữ liệu. Bằng cách này, nó kết nối dữ liệu giao dịch theo thời gian thực với các bản ghi lịch sử của Lakehouse.
Thêm đại lý có căn cứ
Một trong những vấn đề lớn với các tác nhân tự trị là chúng có thể dễ bị ảo giác nếu không có rào chắn thích hợp, đó là lý do tại sao Google đã cải tiến một khả năng khác trong Đám mây dữ liệu tác nhân. Danh mục Kiến thức, một loại bản đồ về ý nghĩa kinh doanh nhằm thông báo cho các tác nhân AI về những đặc thù của tổ chức mà họ làm việc, đang nhận được khả năng làm giàu khả năng tự học mới trong bản xem trước.
Theo Chandrasekaran, nó hoạt động bằng cách liên tục quét dữ liệu phi cấu trúc trong Google Workspace, Jira, SharePoint và GitHub để chuyển kiến thức vận hành sang các bộ ngữ cảnh Định dạng Kiến thức Mở. Những điều này có thể được sử dụng để củng cố kiến thức của các tác nhân AI trong tổ chức và kết quả từ những người áp dụng sớm cho thấy rằng nó có thể giúp làm cho tác nhân trung bình chính xác hơn gấp 4 lần, đồng thời giảm mức tiêu thụ mã thông báo tới 75%.
Danh mục kiến thức được coi là rất quan trọng đối với tương lai đại lý của Google đến nỗi nó cũng được bật theo mặc định trong ứng dụng Gemini kể từ hôm nay. Vì được tích hợp rất chặt chẽ nên nó có thể giải quyết các vấn đề xung quanh định nghĩa số liệu kinh doanh và kiểm soát quyền truy cập trước khi chuyển lời nhắc của người dùng sang truy vấn Ngôn ngữ truy vấn có cấu trúc. Các công ty cũng có thể chọn sử dụng các tác nhân cơ bản trong các mô hình ngữ nghĩa cho các nền tảng dữ liệu cụ thể, bao gồm Google BigQuery, Snowflake, SAP, Looker và dbt.
Chandrasekaran nói: “Các đại lý chỉ chính xác tùy theo bối cảnh kinh doanh mà họ đặt nền tảng. “Cho dù một đại lý đang tính toán doanh thu ròng cho hoạt động tài chính hay lượng khách hàng rời bỏ hoạt động, đại lý đó đều áp dụng các công thức được quản lý giống hệt như các nhóm kinh doanh của bạn dựa vào.”
Gemini cũng đang nhận được các khả năng học máy tự động mới có thể giúp hợp lý hóa công việc hàng ngày cho cả nhóm kỹ thuật và nhân viên kinh doanh. Ví dụ: các kỹ sư dữ liệu giờ đây có thể cho Gemini biết kết quả kinh doanh cụ thể mà họ muốn đạt được bằng ngôn ngữ tự nhiên và Gemini sẽ tạo mã PySpark, chạy sổ ghi chép và sửa mọi lỗi trong đường dẫn dữ liệu khi nó hoạt động hướng tới mục tiêu đó. Trong khi đó, người dùng doanh nghiệp sẽ có thể tạo các báo cáo hoạt động theo thời gian thực, đáng tin cậy trong Gemini chỉ bằng cách yêu cầu.
Chandrasekaran giải thích: “Gemini sử dụng các kỹ năng báo cáo hoạt động được tích hợp với BigQuery và Danh mục kiến thức để xây dựng và lưu truy vấn”. “Sau khi lưu, các nhóm có thể chạy báo cáo theo yêu cầu mà không phải chịu chi phí mã thông báo, đảm bảo các câu trả lời nhất quán và được xác minh mọi lúc.”
Cơ sở hạ tầng đại lý được tăng tốc
Google cũng có một số quà tặng dành cho các nhà phát triển phần mềm, bắt đầu với Bộ tác nhân dữ liệu mới, được cung cấp rộng rãi từ hôm nay, đưa công cụ Giao thức bối cảnh mô hình vào các môi trường phát triển tích hợp như VS Code, Claude Code và AntiGravity. Điều này có nghĩa là các nhà phát triển giờ đây có thể chỉ cần xác định mục đích kinh doanh của họ bằng ngôn ngữ tự nhiên và yêu cầu các đại lý tự động tạo, tinh chỉnh và kiểm tra các đường dẫn dữ liệu liên quan.
Các nhà phát triển cũng có thể tận dụng các bản cập nhật cơ sở hạ tầng được thiết kế để tạo điều kiện thuận lợi cho “tương tác tác nhân đồng thời cao”, để hàng nghìn tác nhân AI có thể truy vấn cùng một cơ sở dữ liệu cùng một lúc mà không làm xáo trộn cơ sở dữ liệu và gây ra sự cố. Chúng bao gồm bản xem trước rộng hơn của AlloyDB Express, một cơ sở dữ liệu có khả năng mở rộng cao, hỗ trợ cung cấp dưới hai giây để tạo nguyên mẫu tác nhân nhanh chóng. Ngoài ra còn có PostgreSQL dành cho các tác nhân trong AlloyDB, cung cấp môi trường khối lượng công việc riêng biệt có thể xử lý ba triệu truy vấn mỗi giây.
Cuối cùng, Google cho biết BigQuery Graph hiện đã có sẵn rộng rãi, đưa các phân tích biểu đồ ở quy mô petabyte vào các bảng cơ sở dữ liệu quan hệ không có ETL. Nó được kết hợp với các bản xem trước của mô hình dự báo TimesFM 3.0 và mô hình phân tích dự đoán TabFM.
Yasmeen Ahmad của Google Cloud, giám đốc điều hành quản lý sản phẩm, dữ liệu và đám mây AI, đã ngồi lại với người sáng lập SiliconANGLE Dave Vellante tại Google Cloud Next, trong buổi phát sóng độc quyền trên theCUBE, studio phát trực tiếp của SiliconANGLE Media, tại Google Cloud Next, nơi cô thảo luận về cách Google đang mô phỏng lại ngăn xếp dữ liệu cho các tác nhân AI:
Ảnh: SiliconANGLE/Gemini
Lời nhắn từ John Furrier, đồng sáng lập SiliconANGLE:
Hãy ủng hộ sứ mệnh của chúng tôi là giữ cho nội dung luôn mở và miễn phí bằng cách tương tác với cộng đồngCUBE. Tham gia Mạng lưới cựu sinh viên đáng tin cậy của theCUBE, nơi các nhà lãnh đạo công nghệ kết nối, chia sẻ thông tin và tạo ra cơ hội.
- Hơn 15 triệu người xem video theCUBE, hỗ trợ các cuộc trò chuyện trên AI, đám mây, an ninh mạng và hơn thế nữa
- 11,4k+ cựu sinh viên theCUBE — Kết nối với hơn 11.400 nhà lãnh đạo doanh nghiệp và công nghệ đang định hình tương lai thông qua mạng lưới dựa trên đáng tin cậy duy nhất
Bạn có phải là khách hàng của AWS không? Hỗ trợ tài chính cho SiliconANGLE bằng cách mua dịch vụ AWS của bạn từ trang và liên kết cổng thông tin Marketplace của chúng tôi: https://siliconangle.com/aws-marketplace/
Giới thiệu về SiliconANGLE Media
Được thành lập bởi những người có tầm nhìn xa về công nghệ John Furrier và Dave Vellante, SiliconANGLE Media đã xây dựng một hệ sinh thái năng động gồm các thương hiệu truyền thông kỹ thuật số hàng đầu trong ngành với hơn 15 triệu chuyên gia công nghệ ưu tú. TheCUBE AI Video Cloud độc quyền mới của chúng tôi đang tạo bước đột phá trong tương tác với khán giả, tận dụng mạng thần kinh theCUBEai.com để giúp các công ty công nghệ đưa ra quyết định dựa trên dữ liệu và luôn dẫn đầu trong các cuộc hội thoại trong ngành.