Amazon SageMaker HyperPod tích hợp NVIDIA Dynamo để tối ưu hóa suy luận mô hình lớn
Tóm lược nhanh
“Amazon SageMaker HyperPod Inference tích hợp khung suy luận phân tán NVIDIA Dynamo nhằm đơn...”
Ý chính
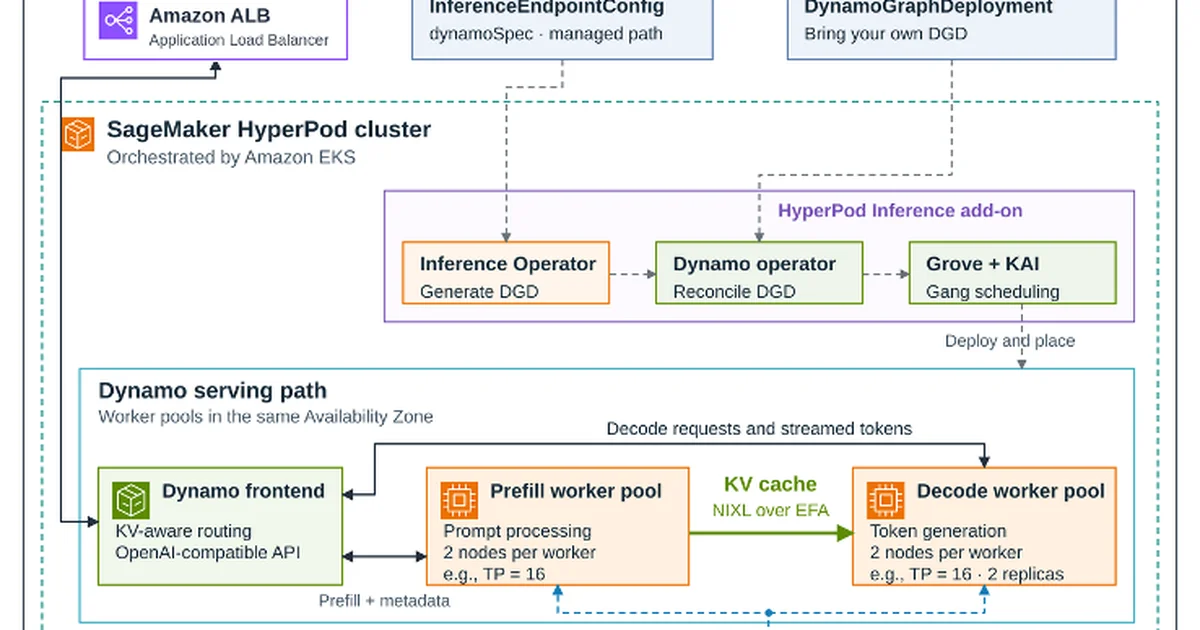
- 1.Amazon SageMaker HyperPod Inference tích hợp NVIDIA Dynamo để kết hợp khả năng suy luận phân tán với các công cụ quản lý cơ sở hạ tầng của HyperPod.
- 2.Khung mã nguồn mở Dynamo hỗ trợ triển khai đa nút, tách biệt khâu tiền xử lý và giải mã cùng định tuyến nhận biết bộ đệm khóa giá trị qua các động cơ vLLM, SGLang và TensorRT-LLM.
- 3.Trong thử nghiệm với mô hình Qwen3-235B sử dụng hai thực thể p5en.48xlarge, cấu hình tách biệt đạt thông lượng đầu ra cao gấp 2,05 lần so với cấu hình gộp.
Amazon SageMaker HyperPod Inference tích hợp khung suy luận phân tán NVIDIA Dynamo nhằm đơn giản hóa việc triển khai các mô hình ngôn ngữ lớn trên nhiều nút. Hệ thống này kết hợp các tính năng định tuyến nhận biết bộ đệm khóa giá trị cùng khả năng tách biệt giai đoạn xử lý nhanh.
Thông tin trọng tâm & Diễn biến chính
Amazon SageMaker HyperPod Inference tích hợp NVIDIA Dynamo để kết hợp khả năng suy luận phân tán với các công cụ quản lý cơ sở hạ tầng của HyperPod.
Khung mã nguồn mở Dynamo hỗ trợ triển khai đa nút, tách biệt khâu tiền xử lý và giải mã cùng định tuyến nhận biết bộ đệm khóa giá trị qua các động cơ vLLM, SGLang và TensorRT-LLM.
Trong thử nghiệm với mô hình Qwen3-235B sử dụng hai thực thể p5en.48xlarge, cấu hình tách biệt đạt thông lượng đầu ra cao gấp 2,05 lần so với cấu hình gộp.
Phân tích chuyên sâu & Tác động
Việc tách biệt giai đoạn tiền xử lý và giải mã giúp các nhóm vận hành tinh chỉnh độc lập từng nhóm tài nguyên GPU, giảm nghẽn cổ chai khi xử lý các đoạn prompt dài.
Sự hỗ trợ mạng lưới hiệu năng cao và tự động thay thế nút lỗi từ HyperPod giúp duy trì độ ổn định cho các cụm máy chủ AI quy mô lớn.
Triển vọng & Các yếu tố cần theo dõi
Hiệu năng thực tế khi áp dụng các cấu hình này trên những kiến trúc phần cứng hoặc mô hình độc quyền khác chưa được làm rõ trong tài liệu.