AIINEWS

AIINEWS

Báo cáo chuyên sâu về Trí tuệ nhân tạo và Công nghệ toàn cầu

Tìm Kiếm Bản Tin

Tra cứu nhanh trong toàn bộ cơ sở dữ liệu các bản tin và phân tích công nghệ

Kết quả cho “inference”24 bản tin
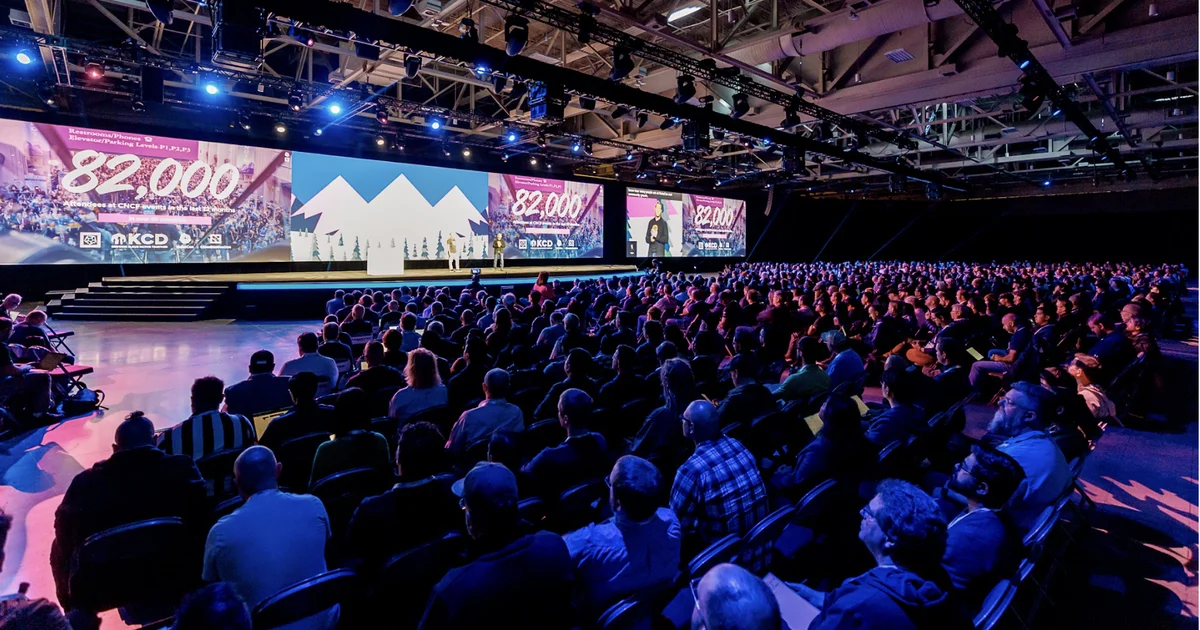
CoreWeave gia nhập cấp hội viên cao nhất của CNCF để giải quyết bài toán triển khai AI trên Kubernetes

CoreWeave gia nhập cấp hội viên cao nhất của CNCF để giải quyết bài toán triển khai AI trên Kubernetes

CoreWeave vừa nâng cấp lên bậc thành viên Bạch kim của Cloud Native Computing Foundation nhằm định hình cách Kubernetes vận hành các mô hình trí tuệ nhân tạo quy mô lớn. Quyết tâm này diễn ra trong bối cảnh việc đưa các mô hình mới ra thị trường đòi hỏi sự can thiệp sâu vào tầng mã nguồn mở.

2 phút đọc5,638
Startup chip AI Anh thu về 720 triệu đô la để phát triển bộ vi xử lý suy luận

Startup chip AI Anh thu về 720 triệu đô la để phát triển bộ vi xử lý suy luận

Công ty thiết kế vi xử lý Fractile vừa hoàn tất vòng huy động vốn mới để đưa ra thị trường dòng chip AI có kiến trúc chồng bộ nhớ DRAM. Khoản tài trợ này đẩy định giá doanh nghiệp lên mức tỷ đô la trong bối cảnh cuộc đua tối ưu hóa tốc độ xử lý mô hình ngôn ngữ lớn đang diễn ra mạnh mẽ.

2 phút đọc6,362
Kora ra mắt hệ điều hành Linux tích hợp sâu trí tuệ nhân tạo cho máy tính Snapdragon

Kora ra mắt hệ điều hành Linux tích hợp sâu trí tuệ nhân tạo cho máy tính Snapdragon

Công ty phần mềm Kora Systems vừa giới thiệu hệ điều hành dựa trên Linux được thiết kế để tích hợp trực tiếp các mô hình và tác nhân trí tuệ nhân tạo vào nhân hệ thống. Dự án này được phát triển cùng Qualcomm nhằm tối ưu hóa hiệu suất trên các máy tính sử dụng chip Snapdragon X2 Elite.

2 phút đọc5,775
Startup Anh quốc huy động 720 triệu đô la để phát triển chip trí tuệ nhân tạo

Startup Anh quốc huy động 720 triệu đô la để phát triển chip trí tuệ nhân tạo

Công ty khởi nghiệp Fractile vừa gọi vốn thành công 720 triệu đô la trong vòng Series C nhằm chế tạo linh kiện phần cứng chuyên dụng phục vụ mô hình trí tuệ nhân tạo. Khoản tài trợ này đẩy định giá doanh nghiệp vượt mức 5 tỷ bảng Anh trong bối cảnh cuộc đua tối ưu chi phí vận hành mô hình lớn đang nóng lên.

2 phút đọc5,778
Hệ thống tự trị thúc đẩy làn sóng ứng dụng mới cho nền tảng điều phối đám mây

Hệ thống tự trị thúc đẩy làn sóng ứng dụng mới cho nền tảng điều phối đám mây

Sự trỗi dậy của các hệ thống trí tuệ nhân tạo tự trị đang tạo ra một vai trò mới cho nền tảng quản lý cụm máy chủ Kubernetes khi khối lượng yêu cầu suy luận tăng vọt. Nền tảng điều phối này đang thích ứng để xử lý các tác vụ phức tạp khi một lệnh đơn lẻ có thể kích hoạt hàng nghìn lần gọi suy luận.

2 phút đọc4,038
Bốn cấu hình yêu cầu suy luận trên Amazon Bedrock tác động ra sao đến chi phí
Công cụ & Workflow AI4 ngày trước

Bốn cấu hình yêu cầu suy luận trên Amazon Bedrock tác động ra sao đến chi phí

Chi phí vận hành mô hình trên Amazon Bedrock có thể tiếp tục tăng ngay cả sau khi đã tinh chỉnh câu lệnh nhờ các lựa chọn ở cấp độ yêu cầu. Các kỹ sư có thể tối ưu hóa ngân sách mà không đổi mô hình bằng cách tinh chỉnh thời gian lưu trữ bộ nhớ đệm, cấp dịch vụ, mức độ tư duy suy luận và giới hạn mã thông báo đầu ra.

3 phút đọc6,004
Amazon Bedrock Hỗ Trợ OpenAI Codex Cho Kỹ Thuật Phần Mềm Doanh Nghiệp
Công cụ & Workflow AI5 ngày trước

Amazon Bedrock Hỗ Trợ OpenAI Codex Cho Kỹ Thuật Phần Mềm Doanh Nghiệp

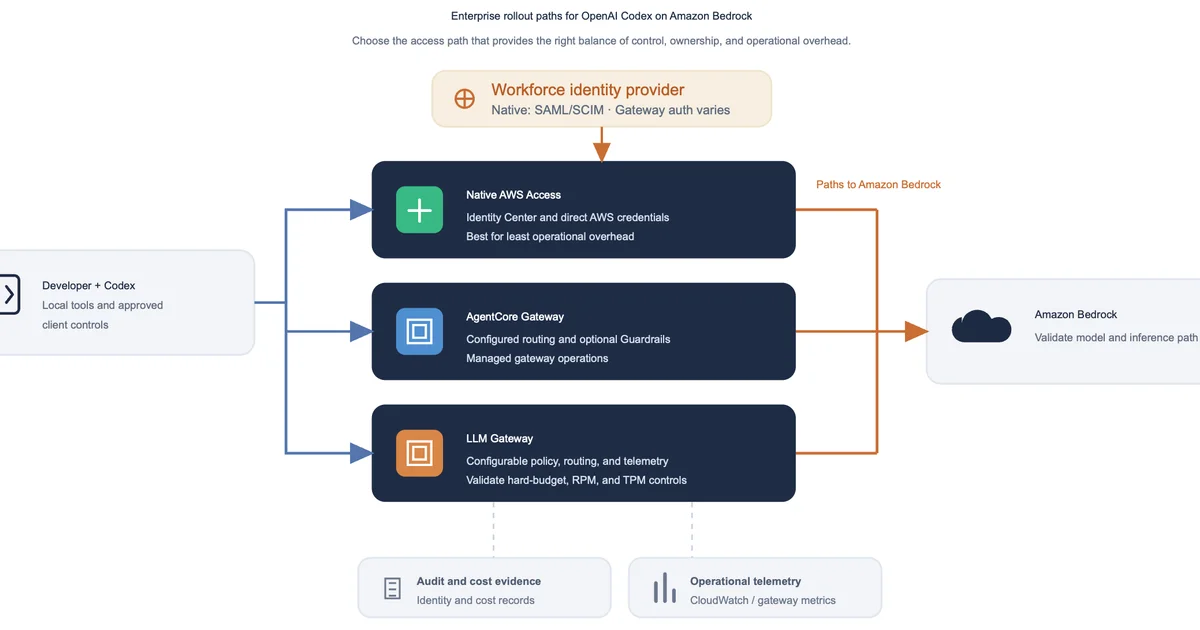
Amazon Bedrock cung cấp một lộ trình để tích hợp OpenAI Codex vào các quy trình định danh, bảo mật và giám sát hiện có của doanh nghiệp. Nằn trong hướng dẫn kỹ thuật mới, các tổ chức có thể triển khai một thí điểm quyền tối thiểu sử dụng Native AWS Access hoặc lựa chọn các cổng kết nối gateway khi cần kiểm soát lưu lượng yêu cầu.

2 phút đọc7,588
Baidu ra mắt hệ thống tự động tối ưu hóa mã nguồn AI
Trí tuệ nhân tạo8 ngày trước

Baidu ra mắt hệ thống tự động tối ưu hóa mã nguồn AI

Baidu vừa giới thiệu ERNIE Evolve, một hệ thống nghiên cứu tự động có khả năng tự đề xuất, chỉnh sửa và thử nghiệm các cải tiến mã nguồn cho mô hình trí tuệ nhân tạo. Hệ thống này đã đạt kết quả vượt trội trên một số tiêu chuẩn đánh giá công khai và giúp tăng tốc độ suy luận cho mô hình ERNIE-5.5-Flash.

2 phút đọc6,766
SageMaker Inference hiện hỗ trợ GPU đa phiên bản để tối đa hóa mức sử dụng GPU cho các điểm cuối của mô hình
Công nghệ toàn cảnh11 ngày trước

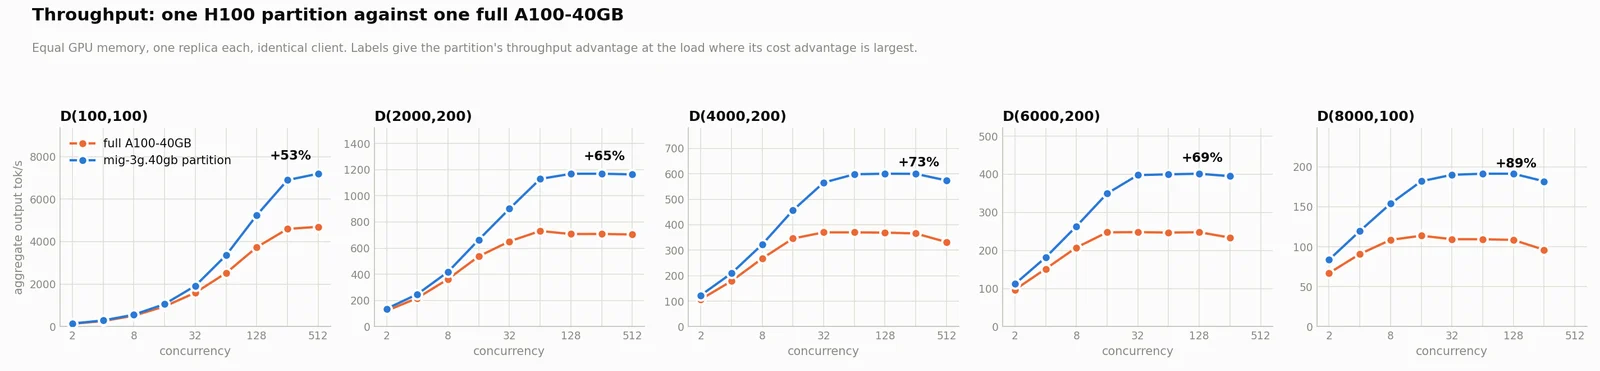
SageMaker Inference hiện hỗ trợ GPU đa phiên bản để tối đa hóa mức sử dụng GPU cho các điểm cuối của mô hình

Khi bạn triển khai một mô hình tới điểm cuối GPU, đơn vị GPU nhỏ nhất bạn có thể yêu cầu là toàn bộ một bộ tăng tốc. Hạn chế này có thể khiến bạn phải trả giá gấp đôi. Đầu tiên, bạn không thể lưu trữ nhiều mô hình trên một phiên bản hơn số lượng mô hình mà nó có.

26 phút đọc5,212